읽지 않는 도구 — 진료 흐름에서 판단을 밖에 두는 법
6 분먼저 두 가지를 밝힌다.
첫째, 2026년 4월에 이 매거진은 어느 의사가 진료 흐름 도구를 만든 이야기를 실었다. 이 현장은 특정 업체가 아니다. 실제로 그렇게 돌아가는 형태를 그대로 구성했고, 어느 곳인지는 밝히지 않는다. 아래는 그 형태대로 직접 만든 것이고, 절차와 수치는 지어낸 것이다.
둘째, 이 글은 의료 조언이 아니고, 여기 만든 것도 의료기기가 아니다. 이 시리즈는 임상 검증을 하지 않았고 할 위치에 있지도 않다. 다루는 것은 소프트웨어의 경계 하나다 — 판단을 도구 밖에 두는 일이 코드에서 어떻게 생겼는가.
말로 긋는 선은 지워진다
원 글에도 그 선이 있었다. "진단은 사람에게 남기고, 진료의 흐름만 화면으로 정리한다."
옳은 말이다. 문제는 그게 문장으로만 있었다는 것이다.
문장으로 있는 선은 지워진다. 특히 이런 식으로 지워진다 — 몇 달 뒤에 누군가 "요약 한 줄 있으면 편하겠는데"라며 필드를 하나 더한다. 그 필드에 대체로 정상 범위 같은 문자열이 들어간다. 아무도 그 순간을 눈치채지 못한다. 도구가 판정을 시작한 순간이다.
그래서 이번엔 코드에 그었다. 두 번.
첫 번째 선 — 그런 도구가 없다
tools offered: flow.state, flow.done, readings.list셋뿐이다. 절차를 보여주고, 절차 하나를 완료로 표시하고, 계측값을 그대로 돌려준다. 판정·분류·해석을 하는 도구가 없다.
검증이 도구 이름부터 본다.
WORDS = ["diagnos", "assess", "judg", "risk", "abnormal", "recommend"]
for n in s.tool_names():
    assert not any(w in n.lower() for w in WORDS), n
이건 앞선 편에서 확인한 원리의 적용이다. 도구 목록이 곧 표면이고, 목록에 없는 능력은 사람이 눌러서도 모델이 골라서도 닿지 않는다.
두 번째 선 — 판정처럼 들리면 예외가 난다
목록만으로는 부족하다. flow.state 가 돌려주는 문자열 안에 판정이 섞일 수 있기 때문이다.
/// Words that would turn a report into a verdict. Anything this server is
/// about to say is checked against them.
///
/// A list of words is a crude guard and it is meant to be. It cannot stop a
/// determined author, but it does stop the ordinary way this line gets
/// crossed: someone adds a helpful-sounding summary field months later and
/// nobody notices that the tool started diagnosing.
static const forbidden = [
  'diagnos', 'likely', 'suggests', 'consistent with', 'probable',
  'abnormal', 'normal', 'healthy', 'concerning', 'severe', 'mild',
  'recommend', 'should take', 'prescribe',
];

static String _guard(String s) {
  final lower = s.toLowerCase();
  for (final w in forbidden) {
    if (lower.contains(w)) {
      throw StateError('clinic_server tried to emit a judgement word: "$w"');
    }
  }
  return s;
}
서버가 내보내는 모든 문자열이 이 함수를 통과한다. normal 이 목록에 있는 것을 봐 달라 — 가장 무해해 보이는 단어이고, 가장 흔히 선을 넘는 단어다.
투박한 가드다. 작정한 사람은 못 막는다. 그런데 이 선이 실제로 지워지는 방식은 작정이 아니라 부주의이고, 부주의는 이 정도로도 막힌다.
그리고 검증이 실행 전체를 훑는다.
no judgement vocabulary in anything the server returned도구가 실제로 하는 일
선을 두 번 그었으니, 남은 것을 보자.
절차를 순서대로 보여준다. 의사가 적은 순서 그대로다.
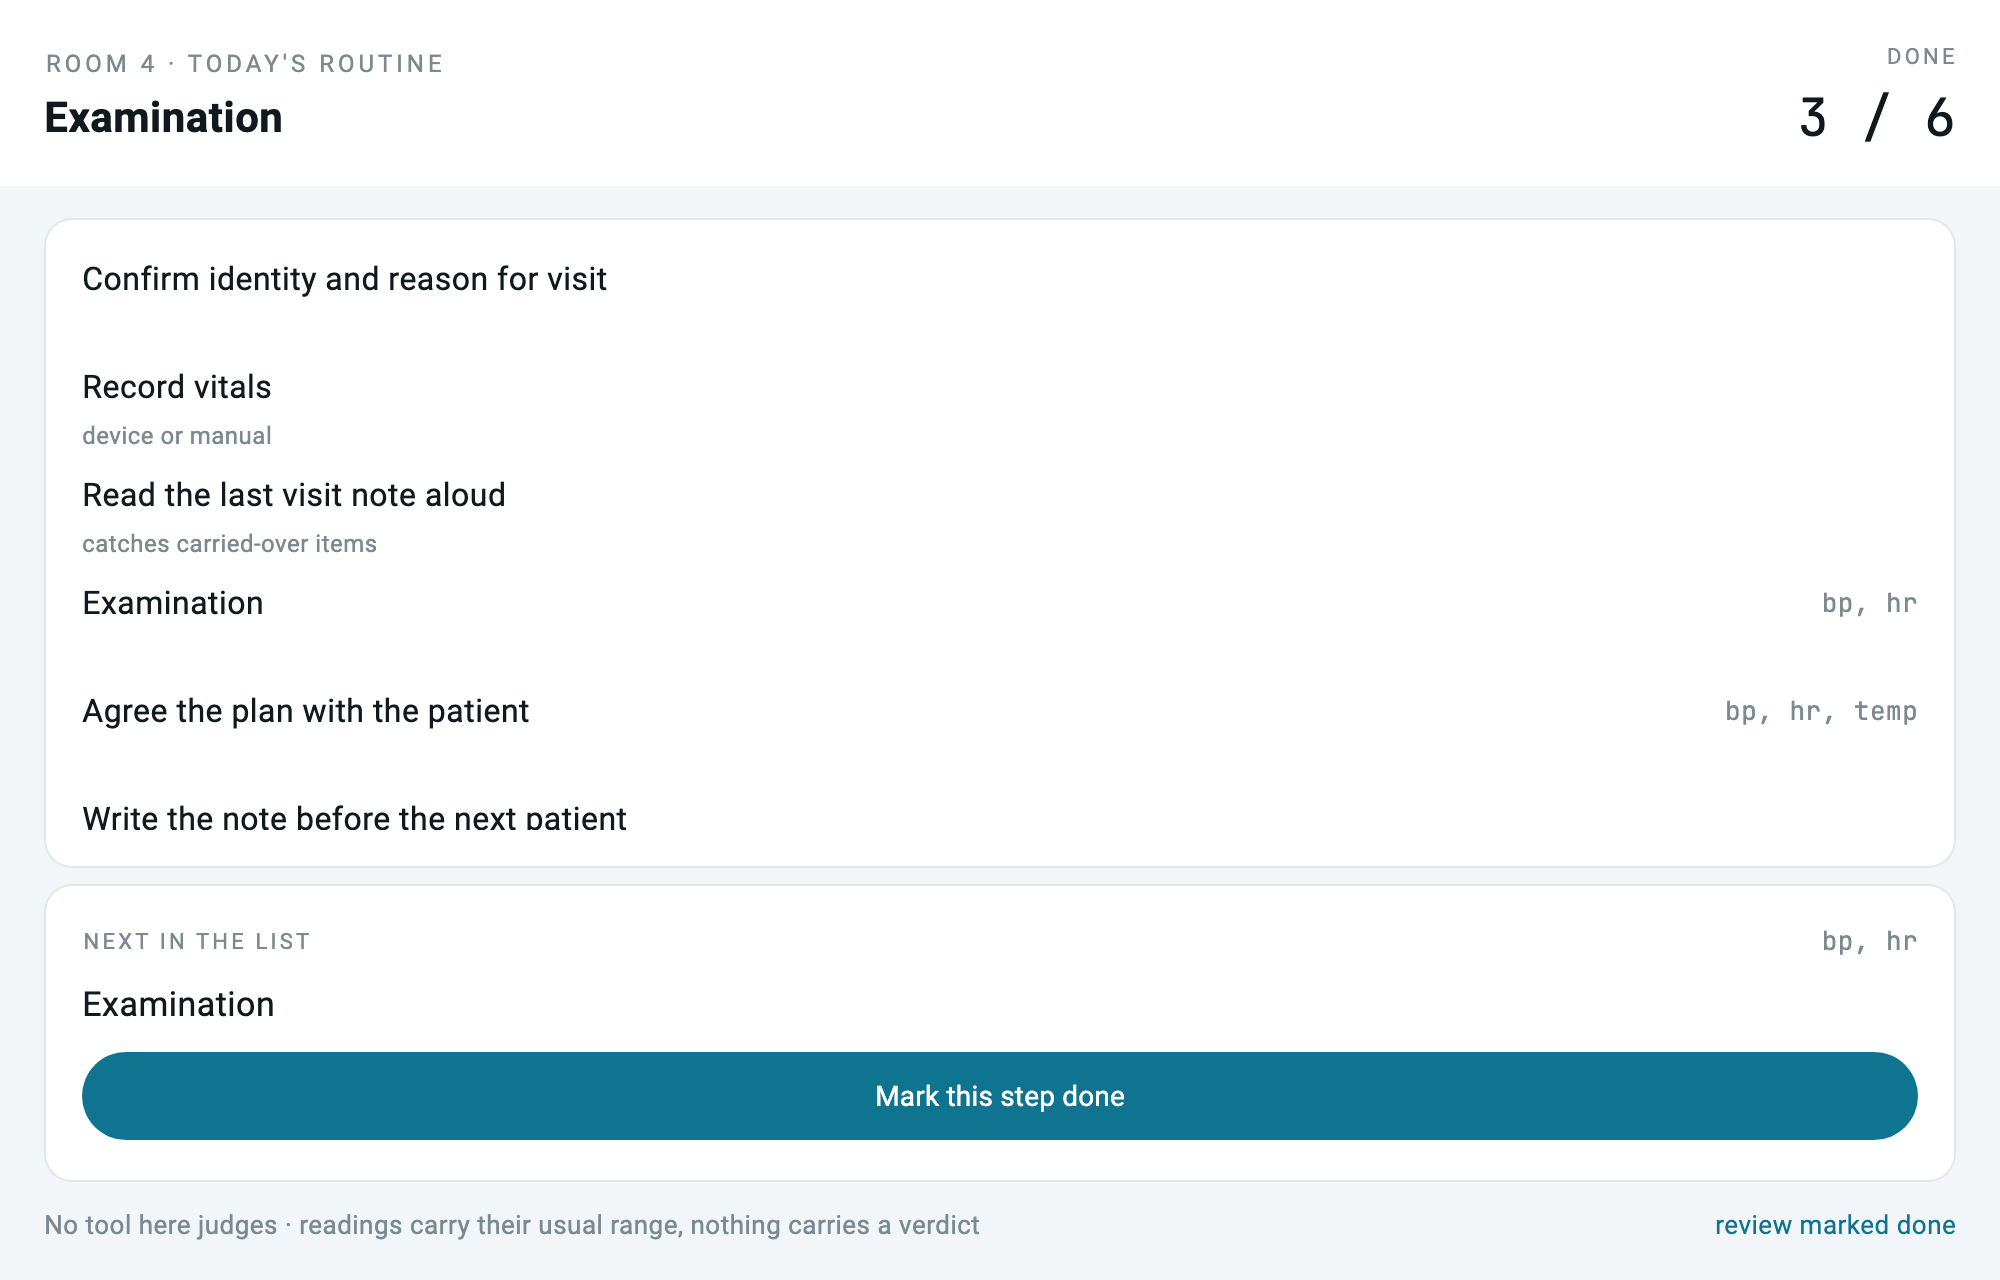
routine: intake* -> vitals* -> review -> exam -> plan -> note* 가 끝난 것이다. 화면 맨 위에 뜨는 것은 다음에 할 것인데, 이것도 조언이 아니다.
// "Next" is position in a list the clinician wrote. It is not advice.
'next': _guard(next.label),
목록에서의 위치일 뿐이다. 이 구분이 사소해 보이지만, "다음엔 이걸 하세요"와 "당신이 적은 순서에서 다음 칸은 이겁니다"는 책임의 위치가 다르다.
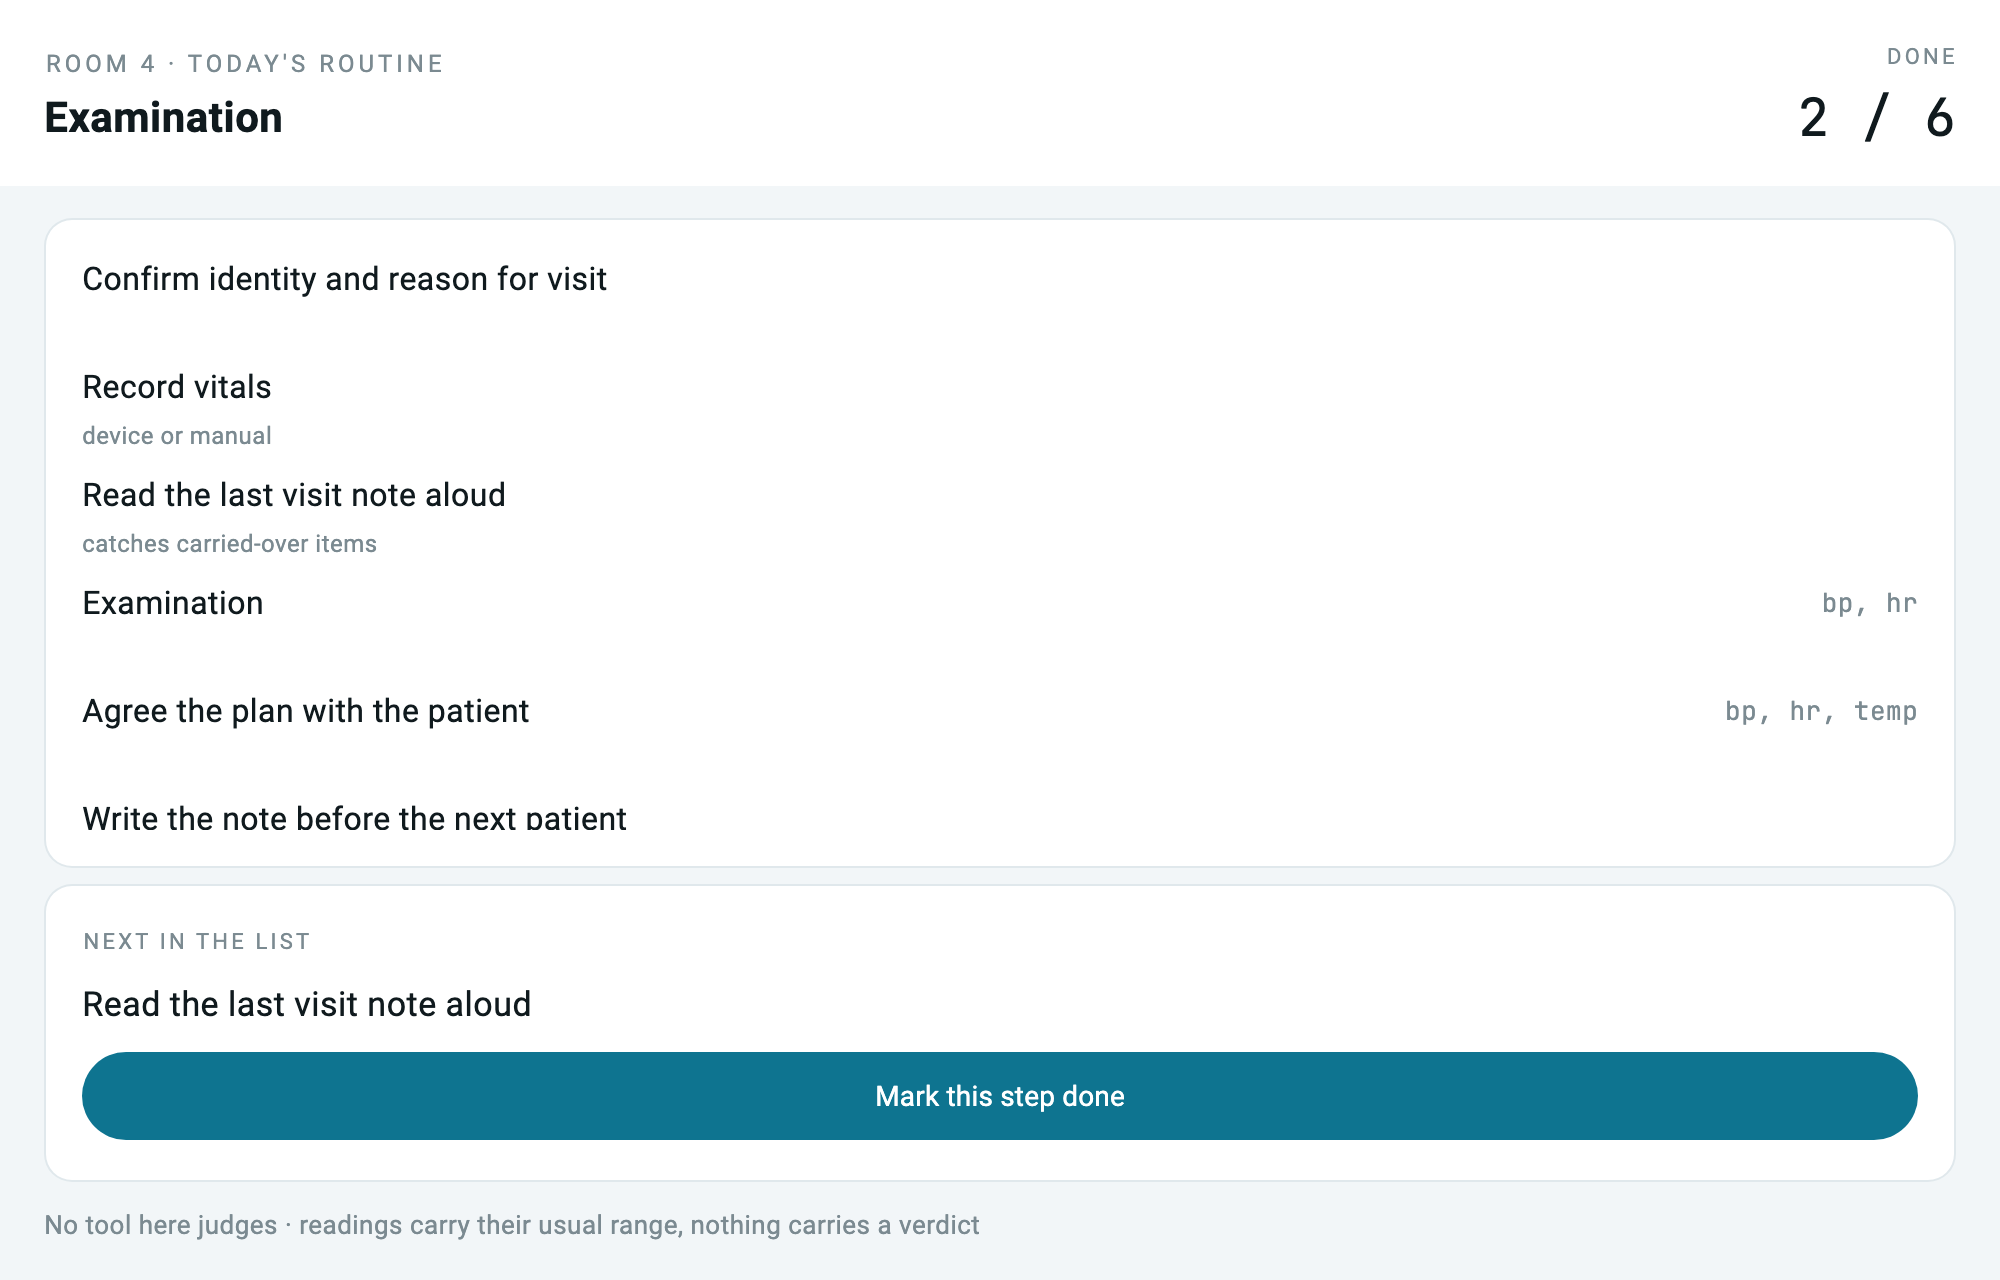
한 단계를 완료로 표시하면 위치만 옮겨간다.
계측값은 그대로 주되, 기준을 옆에 붙인다.
readings: Blood pressure 148/92mmHg (clinic uses <130/80)
        | Heart rate 78bpm (clinic uses 60-100)
        | Temperature 36.8C (clinic uses 36.1-37.2)
148/92 옆에 <130/80 이 있다. 그런데 "높다"고는 하지 않는다. 그 판단은 이 도구의 것이 아니다.
기준을 붙이는 것 자체가 필요한 이유가 있다. 숫자만 있으면 읽는 사람이 판정을 스스로 채워 넣는다. 그리고 그 판정은 어디에도 기록되지 않는다. 기준이 옆에 있으면 최소한 무엇과 견주었는지가 화면에 남는다.
검증도 그걸 본다.
readings = s.call("readings.list")["readings"]
assert len(readings) == 3 and all(r["usual"] for r in readings)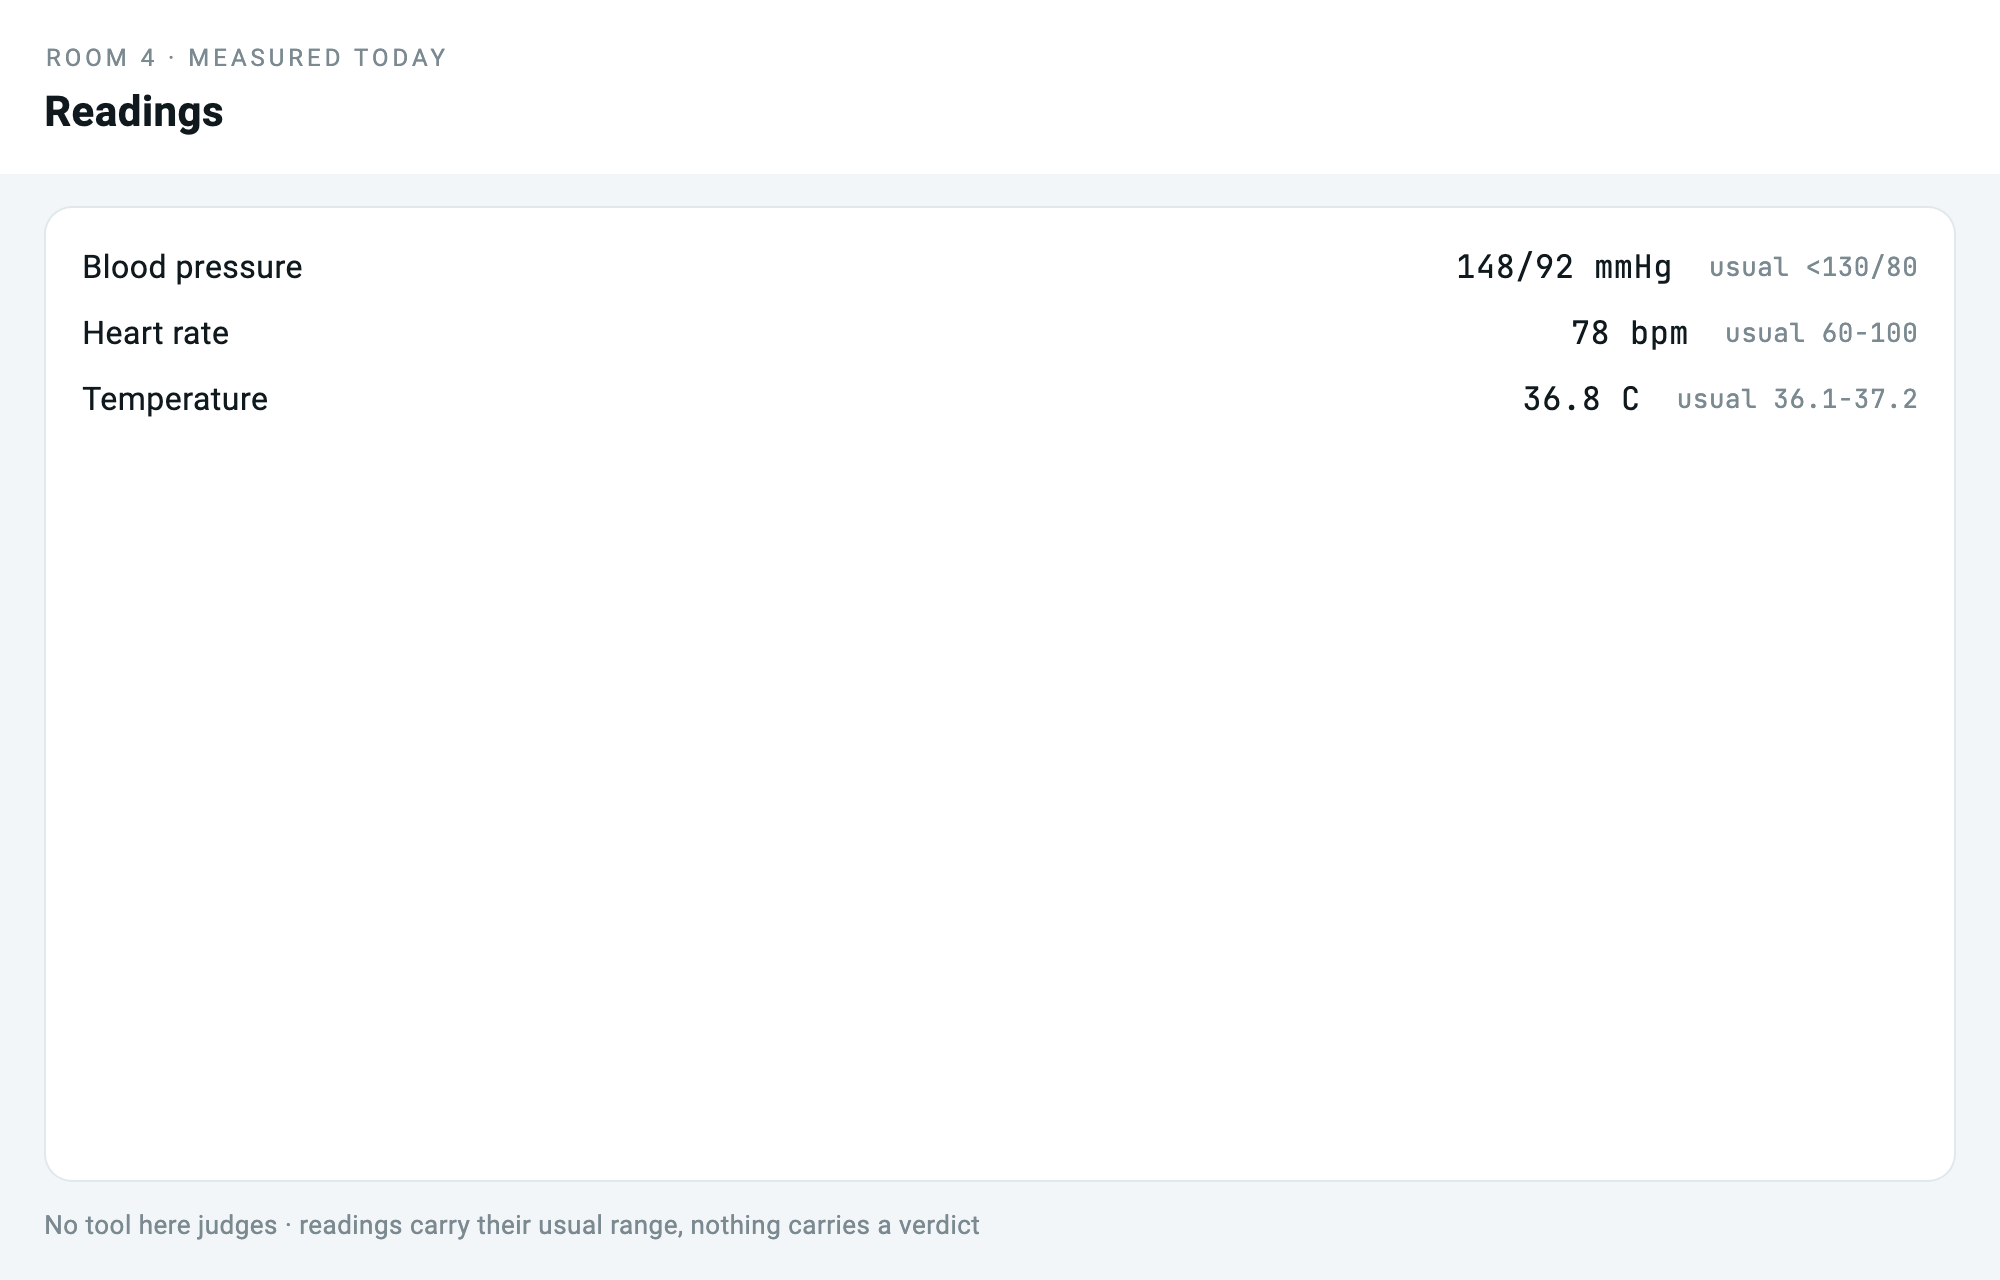
이 샘플의 범위
의사는 없다. 그리고 위 절차와 기준값은 내가 지어낸 것이다. clinic uses <130/80 같은 값은 이 샘플의 숫자이지 어느 진료 지침도 아니다.
이 글이 검증한 것은 소프트웨어의 성질 하나까지다. "이 도구는 판단을 내지 않는다"는 것. 그것이 좋은 진료 도구라는 뜻은 아니다. 임상적으로 유용한지, 안전한지, 규제 요건을 만족하는지는 전부 이 시리즈 밖이고, 그 판단에 필요한 검증을 하지 않았다.
의료기기 규제도 다루지 않았다. 어느 시점부터 이런 소프트웨어가 규제 대상이 되는지는 관할마다 다르고, 이 글은 그 선을 따져 보지 않았다.
가드는 단어 목록이다. 우회하려면 우회된다. 이건 부주의를 막는 장치이지 악의를 막는 장치가 아니다.
하지 않는 것을 코드에 쓰기
원 글의 문장은 옳았다. 진단은 사람에게 남긴다.
만들어 보고 한 줄을 더한다. 그 문장은 코드 어딘가에 실행되는 형태로 있어야 한다. 문서에만 있으면 여섯 달 뒤에 아무도 기억하지 못하고, 기억하지 못하는 원칙은 원칙이 아니다.
이 서버에서 그 형태는 셋이었다.
- 없는 도구 — 목록이 표면이다
- 던지는 가드 — 판정처럼 들리면 예외가 난다
- 실패하는 검증 — 위 둘이 무너지면 통과하지 않는다
셋 다 대단한 기술이 아니다. 다만 셋 다 글이 아니라 코드다. 그 차이가 여섯 달 뒤에 남는다.
확인 과제
설비 예제에서 대답 하나를 골라 그 대답이 인용한 기록을 짚어 보세요. 맞는 기록이 없으면 도구는 무엇을 해야 합니까?