대답 옆에 근거를 붙인다 — 설비에 물어보는 LLM 붙이기
13 분공장 설비 앞에 선 정비 기사가 알고 싶은 건 대개 몇 가지다. 이 기계 정비 주기가 지났나. 진동이 한계 안인가. 손대기 전에 뭘 확인해야 하나.
이 정보는 이미 공장 어딘가에 다 있다. 정비 이력 DB에, 센서 수집 시스템에, 안전 점검표 문서에. 다만 기계 앞에 선 사람이 물어볼 방법이 없다.
그래서 LLM을 붙이면 되겠다는 생각이 자연스럽게 나온다. 그리고 거기서 진짜 문제가 시작된다. "컨베이어 3호 정비 주기 지났습니다"라고 말하는 기계와, 그렇게 말하지만 아무것도 조회하지 않은 기계를 구별할 방법이 없으면, 그 조언을 믿고 기계 안에 손을 넣는 사람이 위험해진다.
이 글은 그 구별을 화면에 올리는 것까지 만들어 본 기록이다. 답 옆에 그 답을 만든 도구 호출이 같이 뜬다. 그리고 도구가 하나도 안 불린 답은 그렇다고 표시된다.
결과부터
기계에 대해 물었다. 답 아래에 그 답을 만든 도구 호출 한 줄이 붙어 있다.
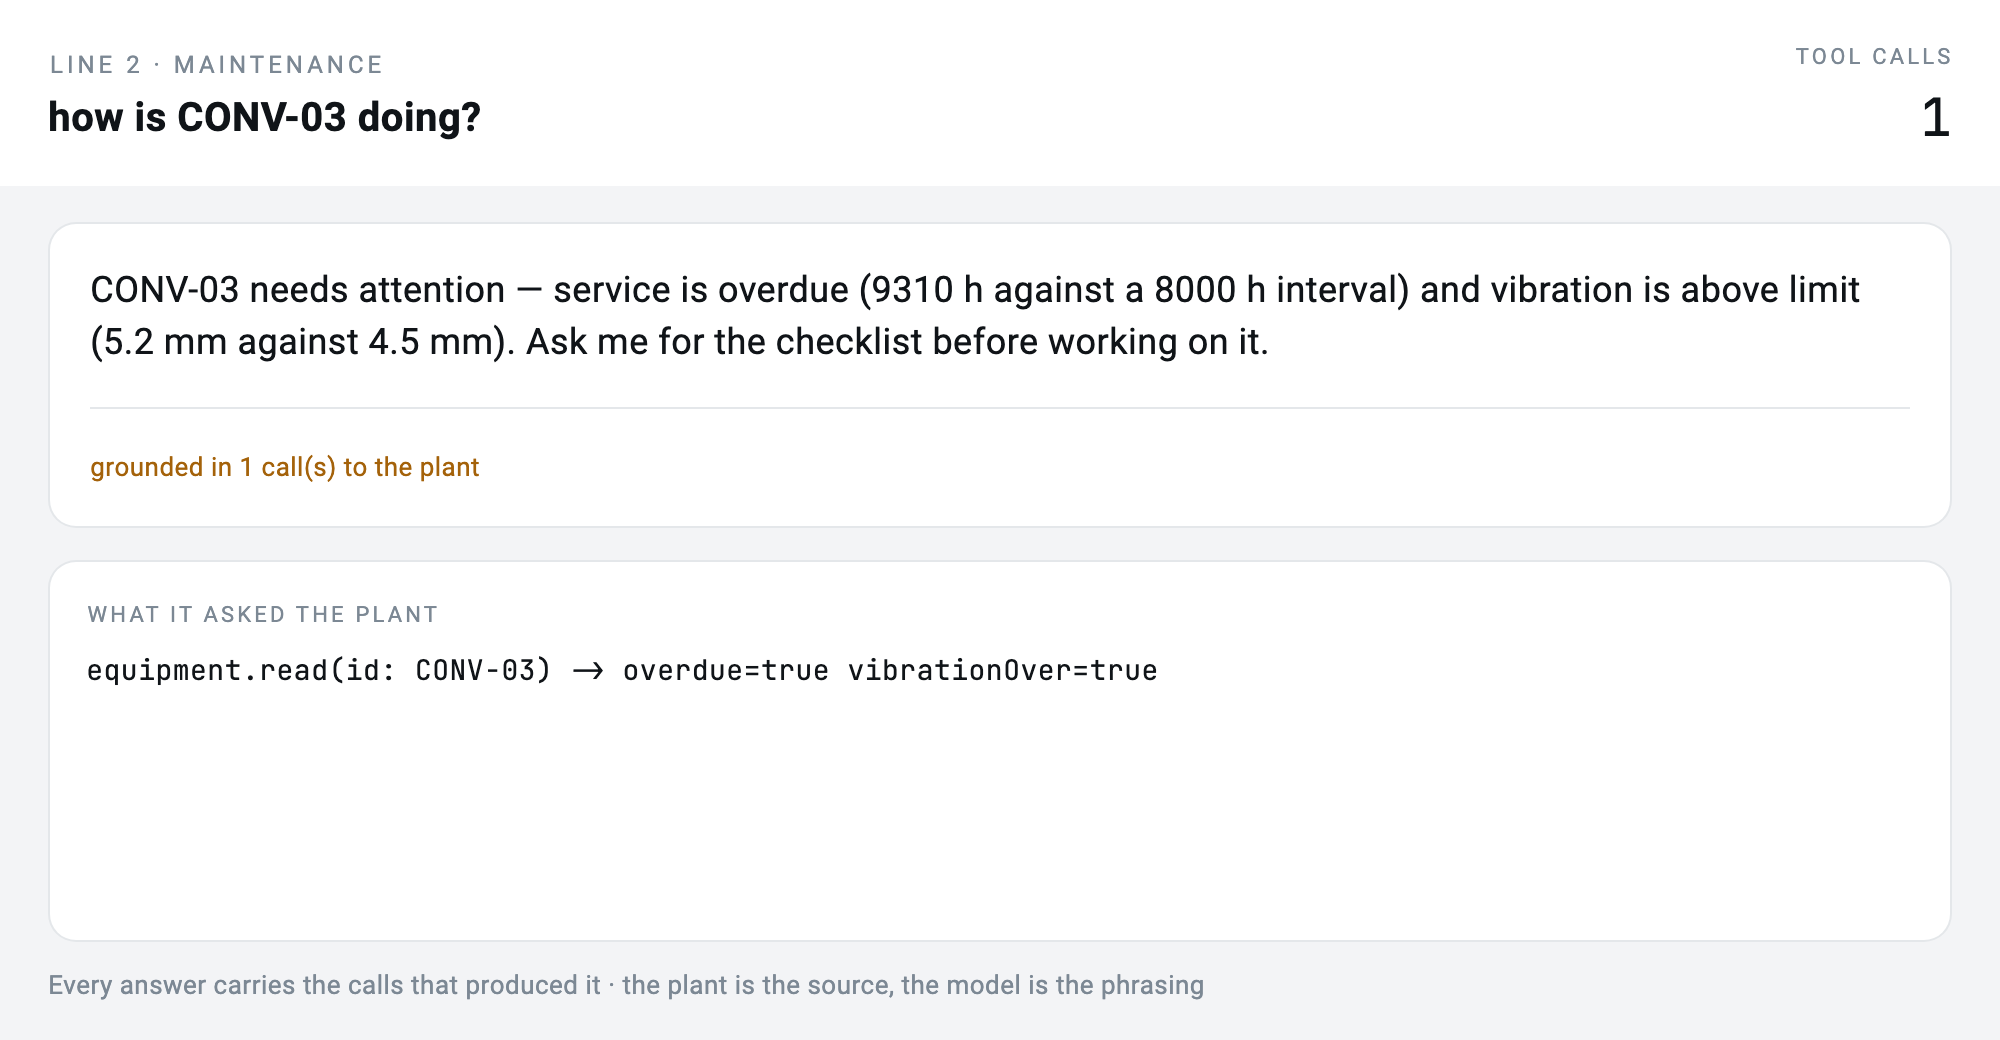
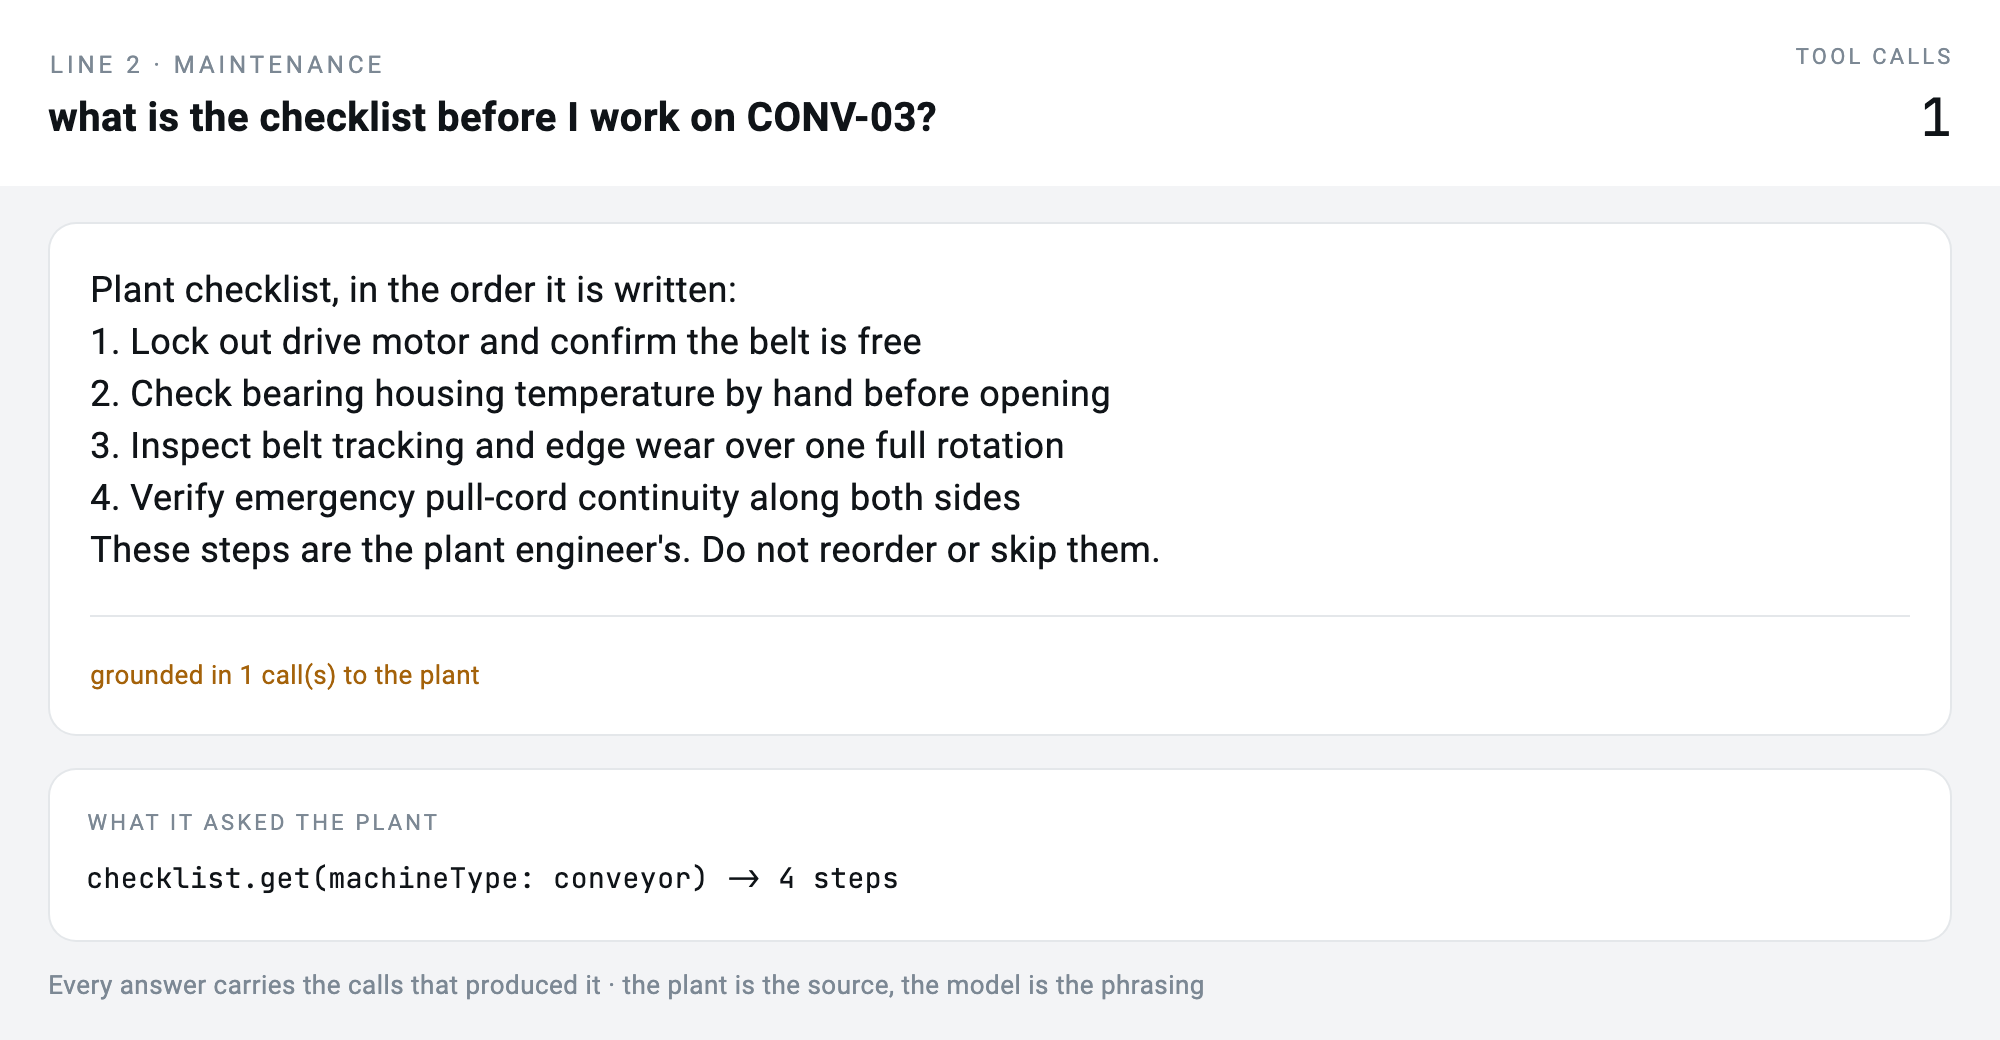
점검표를 물었다. 공장 엔지니어가 쓴 순서 그대로 나온다.
그리고 이게 이 글에서 제일 중요한 화면이다. 공장이 답할 수 없는 질문을 던졌다.
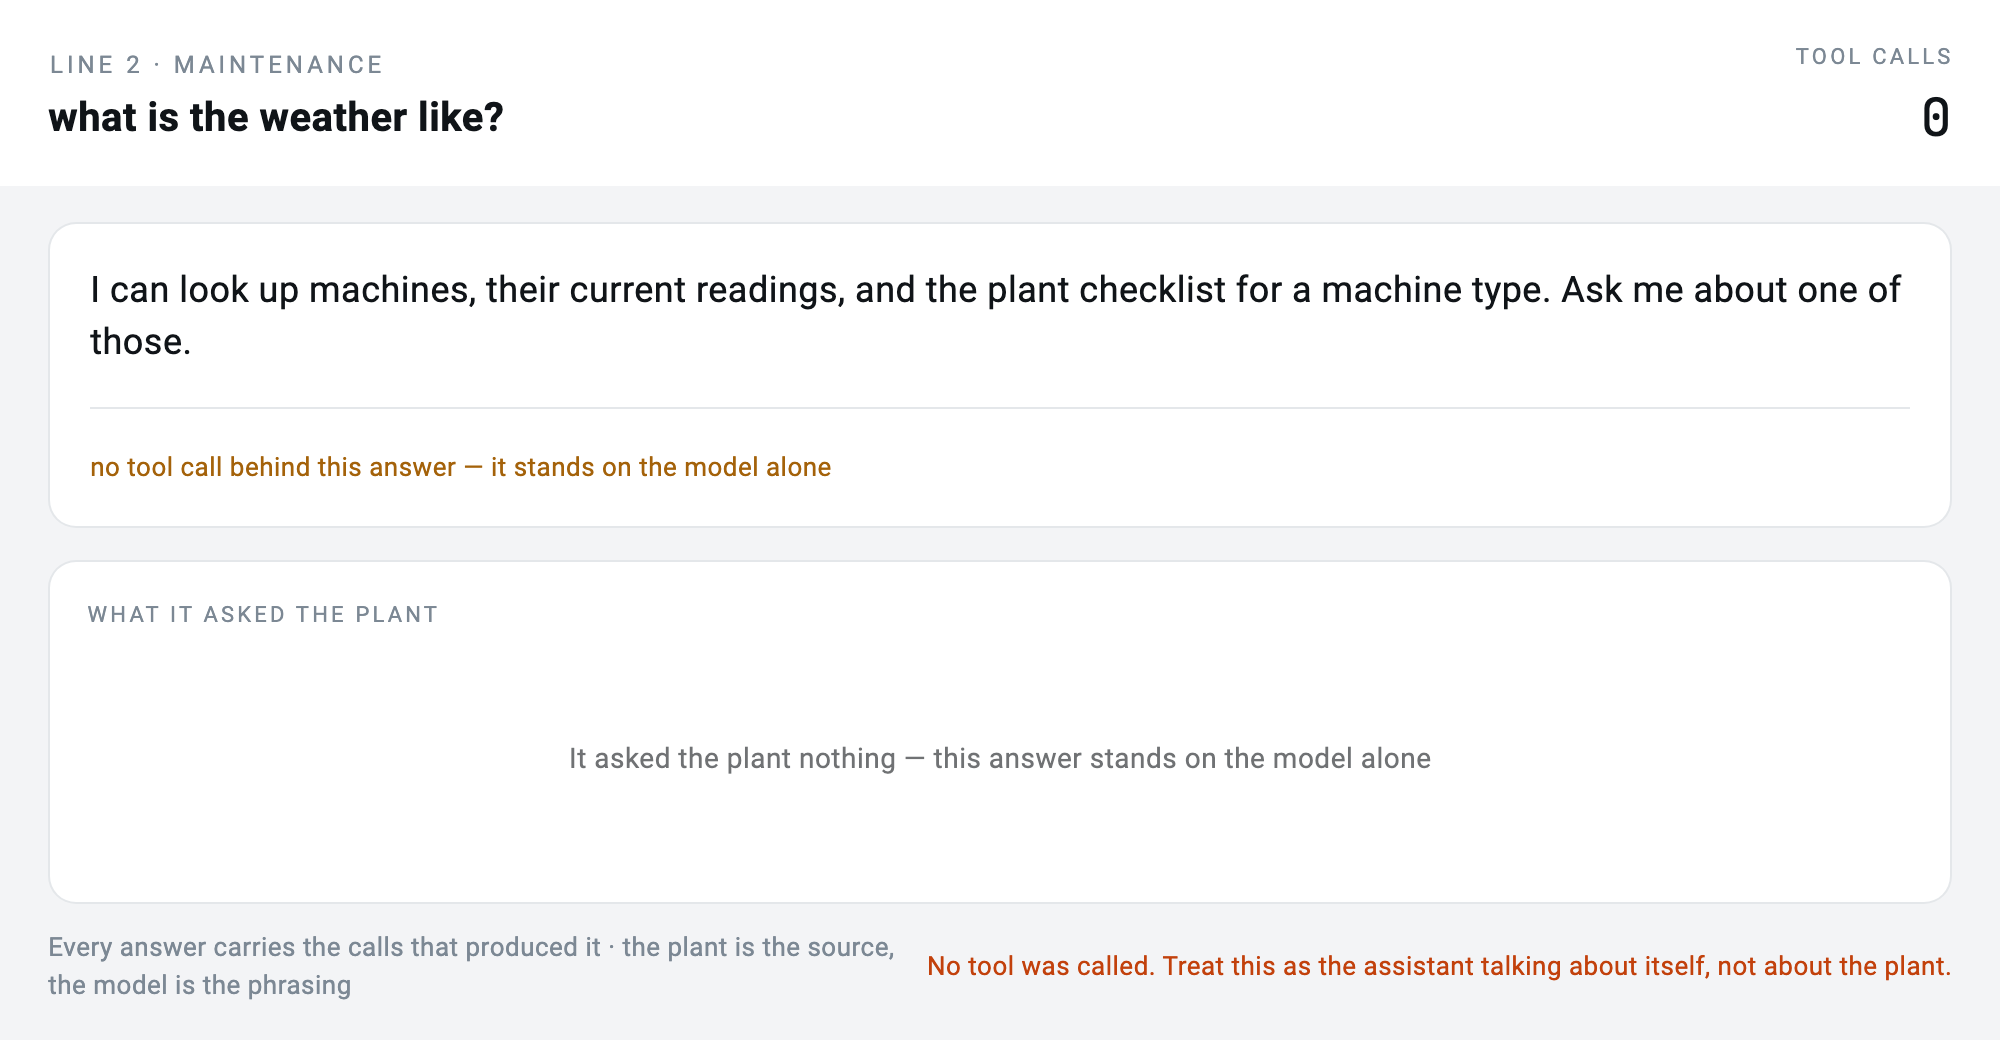
도구가 0건 불렸고, 화면이 그렇게 말한다. 앞의 두 답과 같은 얼굴을 하고 있지 않다.
전체 그림
plant_server (mcp_server)      assistant (client + server)          태블릿
  equipment.list      ◀──MCP──   plant 의 클라이언트                ──MCP──▶  ui://assistant
  equipment.read                 화면의 서버                                   답 + 호출 기록
  checklist.get                  가운데에 모델
가운데 조각의 정체를 먼저 밝혀 둔다. 이 샘플의 모델 자리에는 결정론적 스텁이 들어가 있다. API 키 없이 누구나 돌려서 확인할 수 있어야 하기 때문이다. 그리고 그게 이 글에서 가장 안 중요한 부분이다 — 읽을 값어치가 있는 건 그 양옆의 배선이고, 그 배선은 가운데가 스텁이든 Claude든 똑같다. 교체 지점은 아래에 그대로 보인다.
① 설비 서버는 판단하지 않는다
먼저 도구 쪽. 여기서 한 가지를 의도적으로 안 한다 — "이 기계 괜찮음/위험함"을 서버가 말하지 않는다.
handler: (args) async {
  final id = (args['id'] as String?)?.toUpperCase();
  final m = _machines[id];
  if (m == null) { /* ... */ }

  // 서버는 사실과, 그 사실이 한계와 어떻게 비교되는지를 말한다.
  // 기계가 "괜찮다"고는 말하지 않는다 — 그 단어는 점검표를 든
  // 사람의 것이다.
  final overdue = (m['runHours'] as int) > (m['serviceEveryHours'] as int);
  final vibrationOver =
      (m['vibrationMm'] as num) > (m['vibrationLimitMm'] as num);
  return _json({
    'id': id,
    ...m,
    'serviceOverdue': overdue,
    'vibrationOverLimit': vibrationOver,
  });
}
serviceOverdue: true 는 사실이다. safe: false 는 판단이다. 서버는 앞엣것만 낸다.
점검표도 마찬가지다. 도구 설명(description)에 **"이 단계들은 공장 엔지니어가 정한 것이고 바꿔 쓰면 안 된다"**를 넣었다. 도구 설명은 모델이 실제로 읽는 텍스트다.
server.addTool(
  name: 'checklist.get',
  description:
      'Get the plant safety checklist for a machine type (press, conveyor, welder). '
      'These steps are set by the plant engineer and must not be paraphrased.',
  /* ... */
);
② 배선 — 도구가 모델에 닿는 곳
여기가 이 글의 본론이다. 셋을 잇는다.
// 1. 설비에 붙는다. 특권 채널이 아니라 평범한 MCP 클라이언트다.
final connected = await McpClient.createAndConnect(
  config: McpClient.simpleConfig(name: 'Plant Assistant', version: '1.0.0'),
  transportConfig: const TransportConfig.stdio(
    command: 'dart',
    arguments: ['run', 'bin/server.dart'],
    workingDirectory: '../plant_server',
  ),
);
final mcpClient = connected.get();

// 2. 프로바이더를 등록하고, 둘을 잇는 클라이언트를 만든다.
final bench = BenchProvider();
final llm = McpLlm()..registerProvider('bench', BenchProviderFactory(bench));

final client = await llm.createClient(
  providerName: 'bench',
  config: LlmConfiguration(model: 'bench-1'),
  mcpClient: mcpClient,          // ← 도구가 여기로 들어간다
  systemPrompt: assistantSystemPrompt,
);

// 3. 묻는다. 도구 목록 전달, 도구 호출 실행, 결과 되먹임까지 이 한 줄 안에서 돈다.
final response = await client.chat(question, enableTools: true);
mcpClient: 한 줄이 배선의 전부다. chat(enableTools: true) 이 도구 목록을 모델에 넘기고, 모델이 도구를 부르면 MCP로 실행하고, 결과를 붙여 한 번 더 물어 최종 답을 받는다.
실제 모델로 바꾸는 것도 이 자리다. 샘플에 주석으로 남겨 뒀다.
//      llm.registerProvider('claude', ClaudeProviderFactory());
//      final client = await llm.createClient(
//        providerName: 'claude',
//        config: LlmConfiguration(apiKey: Platform.environment['ANTHROPIC_API_KEY'],
//                                 model: 'claude-sonnet-5'),
//        mcpClient: mcpClient,
//        systemPrompt: systemPrompt,
//      );
//
//    Nothing below this point changes.
두 줄이다. 그 아래는 한 글자도 바뀌지 않는다.
③ 시스템 프롬프트 — 문장마다 이유가 있다
짧게 썼다. 각 문장이 거기 있는 이유는, 그 문장을 빼면 특정한 나쁜 답이 나오기 때문이다.
You help a maintenance technician standing in front of a machine.

Rules:
- Every number you state must have come from a tool result in this conversation.
  If you do not have it, call the tool. Never estimate a reading.
- Safety checklist steps are the plant engineer's. Quote them in order and do
  not paraphrase, shorten or reorder them.
- You do not decide whether a machine is safe to work on. You report what the
  readings are, how they compare to their limits, and what the checklist says.
- If the plant has no tool that answers the question, say so.- 첫 줄을 빼면 지어낸 수치가 나온다. 그럴듯한 진동값은 실제 진동값과 구별이 안 된다.
- 둘째 줄을 빼면 요약된 안전 절차가 나온다. 4단계를 3단계로 줄인 점검표는 점검표가 아니다.
- 셋째 줄을 빼면 판단이 나온다. "작업해도 됩니다"는 이 시스템이 할 말이 아니다.
- 넷째 줄을 빼면 모르는 걸 아는 척한다.
다만 프롬프트는 부탁이지 보장이 아니다. 그래서 다음 절이 필요하다.
④ 근거를 세는 곳
프롬프트로 "도구를 써라"라고 말해 놓고 실제로 썼는지 안 보면, 안 쓴 답과 쓴 답이 화면에서 똑같이 생겼다. 그래서 질문 하나가 유발한 도구 호출만 정확히 떼어 낸다.
// 설비 감사 로그의 현재 지점을 표시해 둔다. 그래야 이 질문이 유발한 호출만
// 귀속시킬 수 있다 — 부팅 이후 전부가 아니라.
final before = await _auditCalls();
final response = await llm.chat(question, enableTools: true);
final after = await _auditCalls();

_answer = response.text.trim();
_toolCalls = after.sublist(before.length);
_notice = _toolCalls.isEmpty
    ? 'No tool was called. Treat this as the assistant talking about '
      'itself, not about the plant.'
    : '';
그리고 세는 쪽에서 자기 호출은 빼야 한다.
// audit.log 자체도 도구 호출이지만 그건 우리 것이지 어시스턴트의 것이 아니다 —
// 세면 모든 답의 근거가 하나씩 부풀어 오른다.
return calls.cast<String>().where((c) => !c.startsWith('audit.log')).toList();
⑤ 만들다 고친 것 — 0건인데 초록색이었다
캡처를 처음 찍고 보니 근거 0건인 화면에 "Built from 0 tool call(s)" 이 초록색으로 떠 있었다. 문장은 맞다. 그런데 공장 바닥에서 흘깃 보는 사람에게 초록색은 "확인됨, 이상 없음"으로 읽힌다. 의미가 정반대다.
// 근거 개수는 근거가 없을 때 안심시키는 얼굴을 하면 안 된다.
// "0 tool calls" 에 초록색은 흘깃 보면 "확인됨, 이상 없음"으로 읽히고,
// 그건 뜻하는 바의 정반대다.
{
  'type': 'conditional',
  'condition': '{{grounded}}',
  'then': { /* 초록, N건 */ },
  'else': {
    'type': 'text',
    'content': 'Not built from any plant data',
    'style': {'fontSize': 13, 'fontWeight': 'bold', 'color': _accent},
  },
},
렌더된 픽셀을 눈으로 보지 않았으면 못 잡았을 종류의 결함이다. 로그에는 grounded=false calls=0 이라고 정확히 찍혀 있었으니까.
⑥ 실행·검증 로그
[+ 2240ms] assistant up — it is a client of the plant and a server to us
[+ 2253ms] assistant offers: assistant.ask, assistant.state
[+ 2722ms] Q: how is CONV-03 doing?
[+ 2723ms]    grounded=true calls=1 equipment.read(id: CONV-03) -> overdue=true vibrationOver=true
[+ 2723ms]    A: CONV-03 needs attention — service is overdue (9310 h against a 8000 h
              interval) and vibration is above limit (5.2 mm against 4.5 mm).
[+ 2894ms] Q: what is the checklist before I work on CONV-03?
[+ 2894ms]    grounded=true calls=1 checklist.get(machineType: conveyor) -> 4 steps
[+ 3028ms] Q: what is the weather like?
[+ 3028ms]    grounded=false calls=0
[+ 3029ms]    A: I can look up machines, their current readings, and the plant checklist
              for a machine type. Ask me about one of those.
CLI 로도 같은 사슬을 돌릴 수 있고, 이쪽은 설비가 실제로 받은 호출을 전부 보여준다.
# tools offered by the plant: equipment.list, equipment.read, checklist.get, audit.log

# tool calls the plant actually received (4):
#   equipment.list(line: A) -> 2 machines
#   equipment.read(id: CONV-03) -> overdue=true vibrationOver=true
#   checklist.get(machineType: conveyor) -> 4 steps
#   equipment.read(id: PRESS-01) -> overdue=false vibrationOver=false

# provider decisions (9):
#   chose equipment.list(line: A)
#   answer from tool result (141 chars)
#   ...
#   no tool matched — declined to guess
빌드는 이렇게 통과한다.
$ dart analyze     # plant_server
No issues found!
$ dart analyze     # assistant
No issues found!
$ bash verify.sh
   [player] open in AppPlayer, ask three questions
plant-assistant: two grounded answers with their calls on screen, one ungrounded answer flagged
검증 스크립트는 통과 조건을 이렇게 잡았다. 답이 나왔다는 것만으로는 통과가 아니다.
# an answer about a machine must have reached the plant
reading = s.call("assistant.ask", {"question": "how is CONV-03 doing?"})
assert reading["grounded"], "a question about a machine must reach the plant"

# an unanswerable question must not have invented tool calls
weather = s.call("assistant.ask", {"question": "what is the weather like?"})
assert not weather["grounded"] and weather["notice"], weather

# and the checklist reaches the screen as a quotation
ap.wait_text("checklist.get")
실측치와 그 범위
| 값 | |
|---|---|
| 설비가 제공한 도구 | 4 |
| 질문 3건이 유발한 도구 호출 | 2 (근거 있는 답 2건에 각 1) |
| 답할 수 없는 질문의 도구 호출 | 0 |
| 화면 렌더까지 왕복 | 질문당 약 120~150 ms (스텁 모델 기준) |
응답 시간 수치는 의미가 제한적이다. 스텁 모델은 즉시 답하므로, 여기 찍힌 120~150 ms 는 사실상 MCP 왕복 두 번과 렌더 비용이다. 실제 모델을 붙이면 그 사이에 추론 지연이 통째로 들어간다 — 그건 재지 않았다.
범위 밖. 실제 모델이 이 도구들을 얼마나 정확히 고르는지, 시스템 프롬프트가 얼마나 잘 지켜지는지, 도구가 수십 개로 늘었을 때 선택 정확도가 어떻게 되는지. 셋 다 실제 모델 없이는 잴 수 없고, 이 글은 그 부분을 측정했다고 주장하지 않는다. 이 글이 보인 것은 배선과 근거 표시 구조다.
이 샘플의 범위
이 문장을 흐리지 않겠다. 스텁이 도구를 "고르는" 것은 질문에서 기계 이름을 찾는 정규식이고, 실제 모델의 판단과는 다르다. 이 글이 증명한 것은 배선이 실제로 돈다는 것과 근거를 세어 화면에 올리는 구조가 성립한다는 것이지, 모델이 도구를 잘 고른다는 것이 아니다. 후자를 주장하려면 실제 모델로 다시 재야 한다.
그리고 설비 데이터도 시뮬이다. 기계 이름·운전 시간·진동값·점검표는 이 샘플이 지어낸 것이지 어느 공장의 실제 데이터가 아니다.
⑧ 직접 돌려보기
샘플은 content/sample/plant-assistant/ 에 자기완결로 들어 있다.
( cd plant_server && dart pub get )
( cd assistant && dart pub get )

# ask from the CLI
cd assistant
dart run bin/ask.dart                        # five prepared questions
dart run bin/ask.dart "how is PRESS-01 doing?"
클라이언트는 AppPlayer 표준판 기준이다. Pro가 필요하지 않다.
가져갈 것
- 배선 3단계 —
bin/ask.dart의 1·2·3 단계. MCP 클라이언트 → 프로바이더 등록 →createClient(mcpClient:)→chat(enableTools: true) - 근거 귀속 —
_auditCalls()앞뒤 차분으로 질문별 호출만 떼어 내는 부분. 자기 호출 제외까지 - 판단하지 않는 도구 설계 — 사실과 한계 비교까지만 내고 "안전함"은 안 내는 핸들러
내 것으로 바꾸려면 어디를 고치나
실제 모델로 — bin/server.dart 의 registerProvider 와 createClient 두 줄이다. BenchProviderFactory 를 ClaudeProviderFactory 로 바꾸고 LlmConfiguration 에 키와 모델명을 넣는다. 그 아래는 바뀌지 않는다.
내 설비 데이터로 — plant_server/bin/server.dart 의 도구 핸들러다. 지금은 상수 맵을 읽지만 정비 DB나 수집 시스템을 조회하도록 바꾼다. 도구 이름과 반환 모양이 같으면 어시스턴트 쪽은 그대로다.
도구를 늘리려면 — addTool 한 덩이. 그리고 설명문을 잘 쓰는 게 코드보다 중요하다 — 모델이 도구를 고르는 근거가 그 문장이기 때문이다.
그래서 이 구조가 파는 것
전문가 지식 시스템 제안서에 이런 문장이 있다 — "전문가 개인의 머릿속에 있던 노하우를 지식 그래프로 체계적 이식." 이 글은 그 앞 칸을 갚는다. 노하우를 옮기기 전에, 옮긴 것이 실제로 조회됐는지 보이는 구조가 먼저 있어야 한다.
정비 기사에게 파는 것은 "AI가 알려준다"가 아니다. "이 답은 이 기계의 이 값을 조회해서 나왔다" 가 화면에 같이 있다는 것이다. 그게 없으면 현장에서 쓰이지 않는다.
회수하지 못한 것을 적어 둔다. 제안서가 함께 말한 자문료 결제 연동과 지식 그래프 축적은 이 편에서 다루지 않았다. 그리고 앞서 말한 대로 모델의 도구 선택 정확도는 이 글의 측정 범위 밖이다.
확인 과제
설비 예제에서 대답 하나를 골라 그 대답이 인용한 기록을 짚어 보세요. 맞는 기록이 없으면 도구는 무엇을 해야 합니까?