リトライが払わせる代償 — かける側ではなく、受ける側
7 分レジがない間の末尾にこう書いた。
自動リトライがない。 ハーネスが明示的に繋ぎ直した。実際のアプリなら裏で周期的に試みるべきであり、その周期とバックオフはここで決めなかった。
この編がその周期を決める。そして決めるついでに、周期を間違えて決めると何が起きるかを測る。
受ける側から数える
リトライの記事の大半はかける側の話だ — どうやって自分のリクエストを通すか。
このサンプルのサーバーは反対側に立つ。試行が何回来たか、そしてそのうち何回が同じ200ミリ秒の中に集中したかを数える。
/// That second number is the one that matters. A gateway that is briefly down
/// does not care that you tried again. It cares how many of you tried again at
/// the same instant, because that is what keeps it down.一時的に落ちたゲートウェイはあなたがもう一度かけたという事実に興味がない。興味があるのは何人が同じ瞬間にもう一度かけたかだ。それが落ちたままにさせるものだからだ。
急いでいるときに書かれるもの
/// Try again immediately. This is what gets written when the retry is added in
/// a hurry, and it is the strategy that turns a short outage into a long one.
class NoBackoff extends Backoff {
  @override
  int waitBefore(int n) => n == 1 ? 0 : 20;
}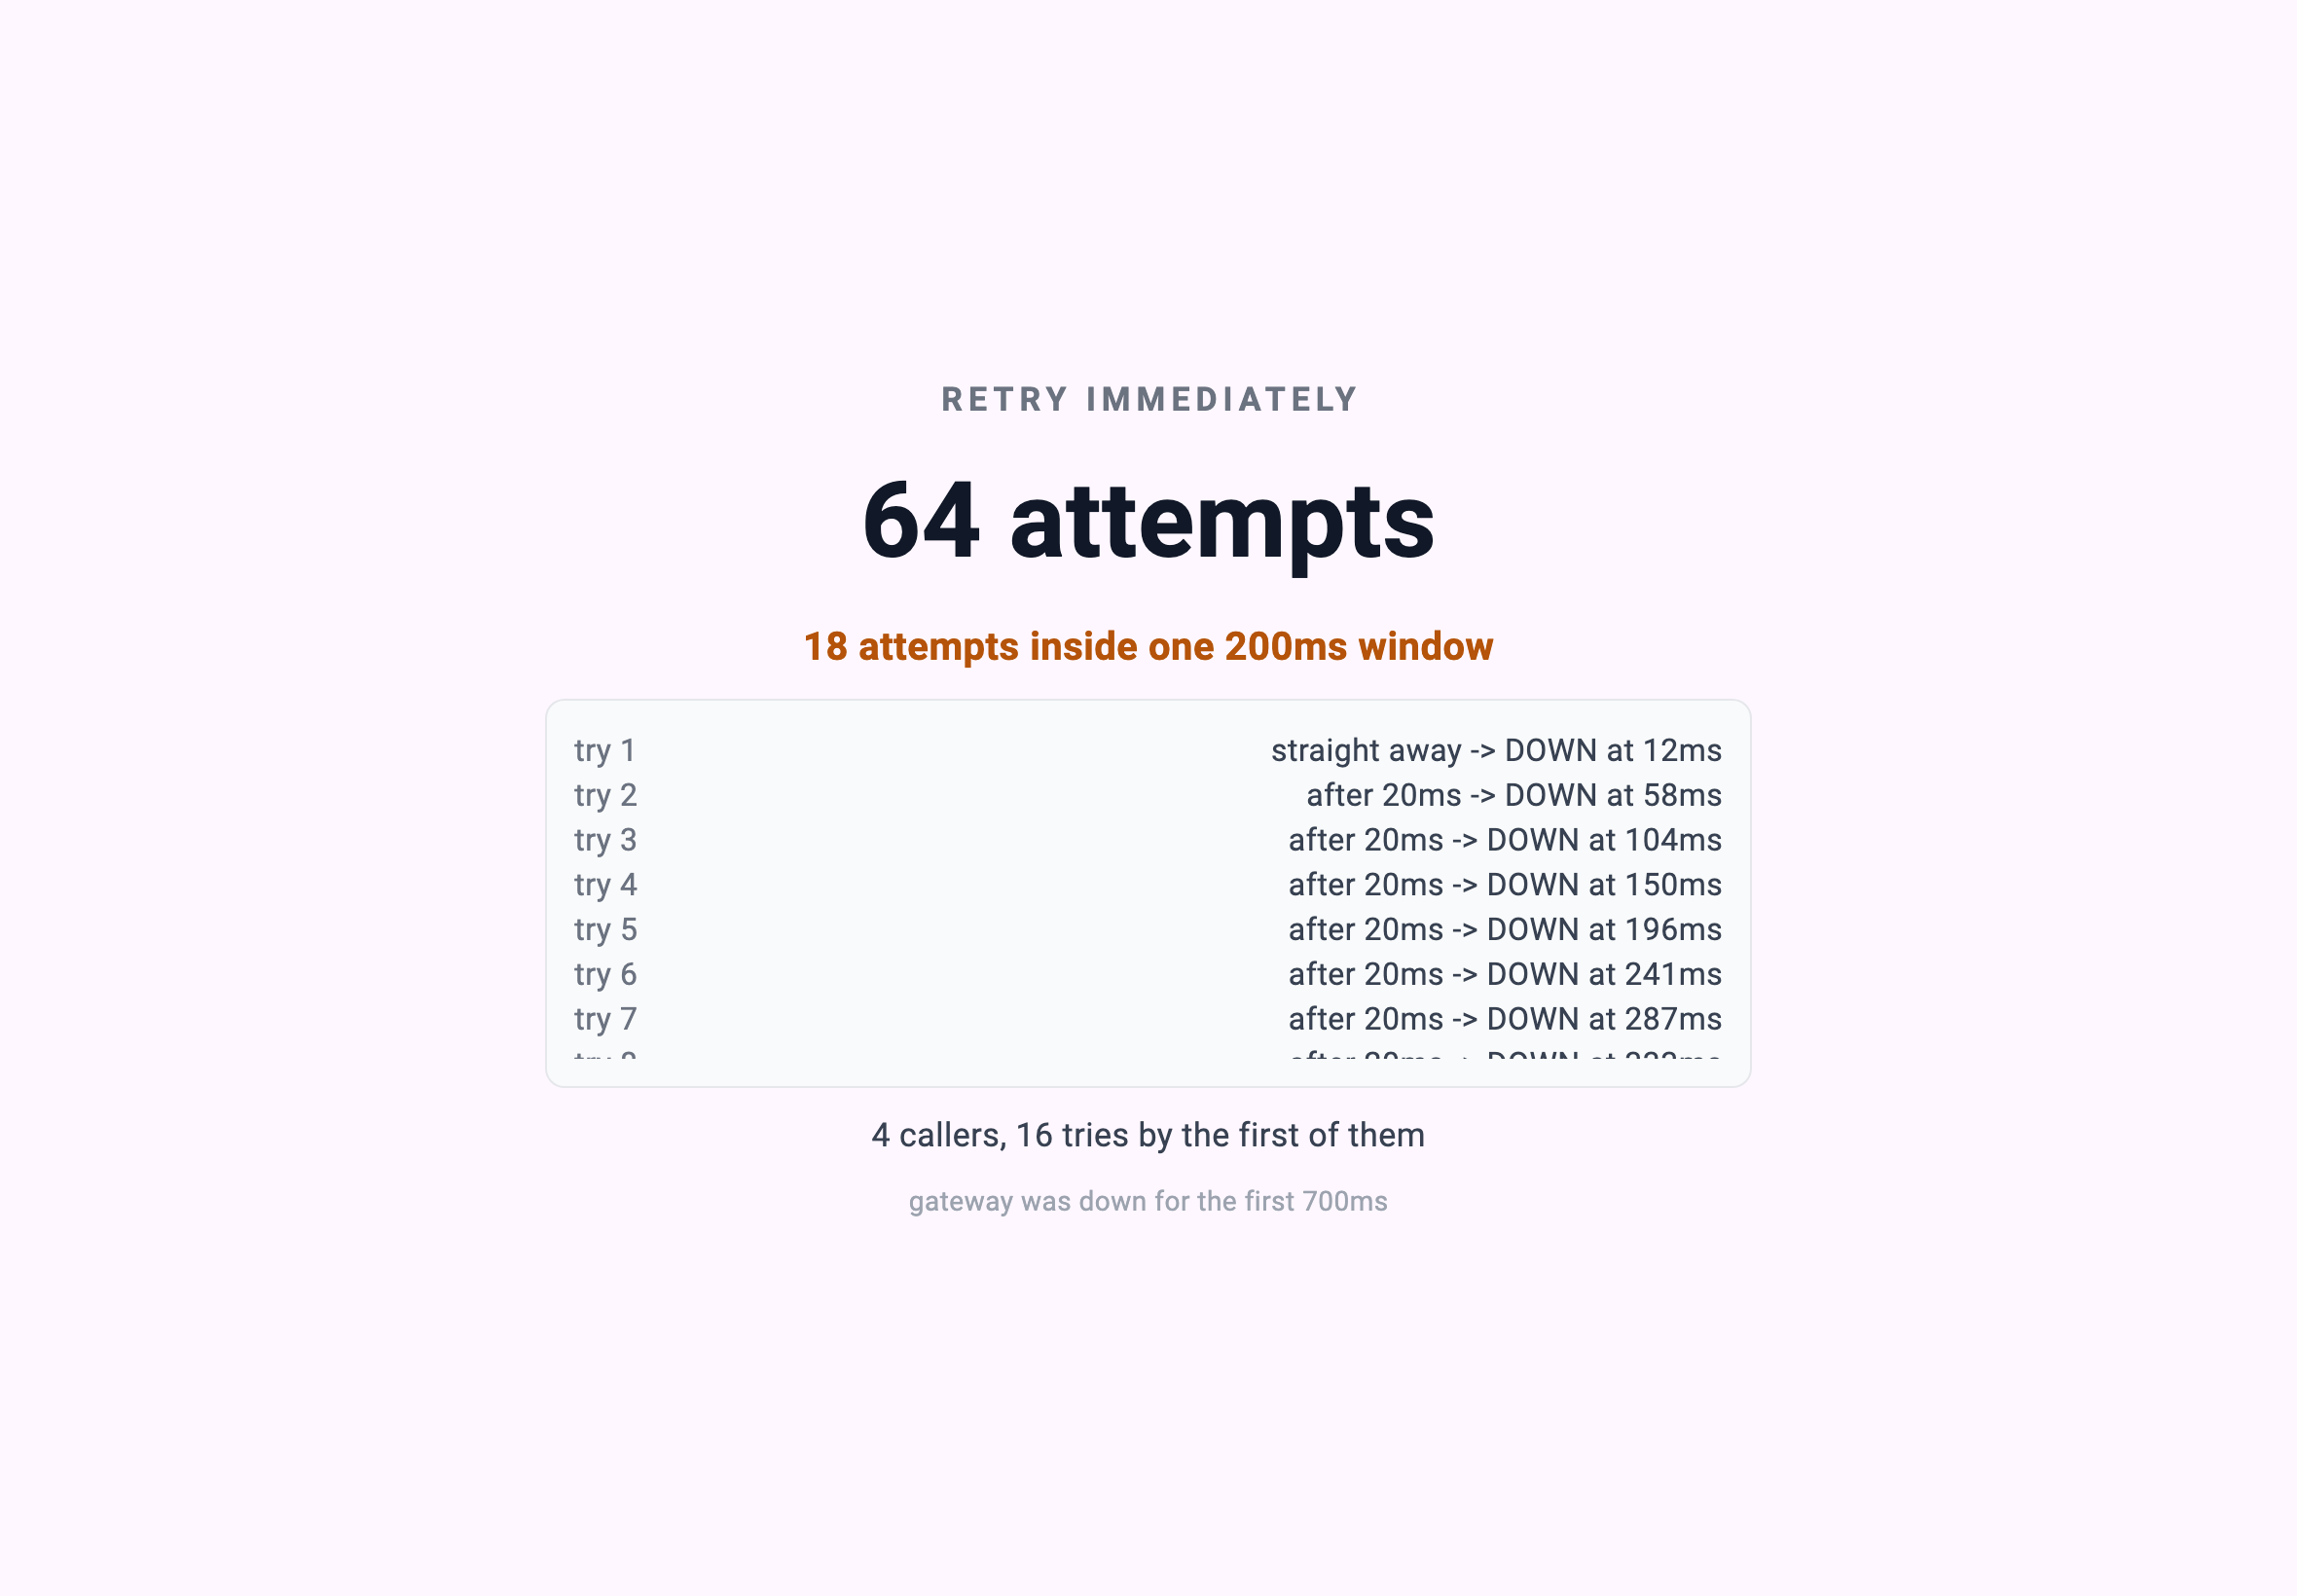
RETRY IMMEDIATELY: 4 callers, 64 attempts total, 4 accepted, peak 18
  caller 1 attempt 1: straight away -> DOWN at 12ms
  caller 1 attempt 2: after 20ms -> DOWN at 58ms
  ...
  caller 1 attempt 16: after 20ms -> ACCEPTED at 708ms
通った。 700ミリ秒の障害を越え、四人とも決済された。
そしてゲートウェイはその間に64回叩かれた。
倍々に伸ばし、揺らす
@override
int waitBefore(int n) {
  if (n == 1) return 0;
  final base = 60 * (1 << (n - 2)); // 60, 120, 240, 480 ...
  // Full jitter: anywhere in [0, base]. Spreading matters more than being
  // punctual — nobody is waiting on an exact millisecond here.
  return _rng.nextInt(base + 1);
}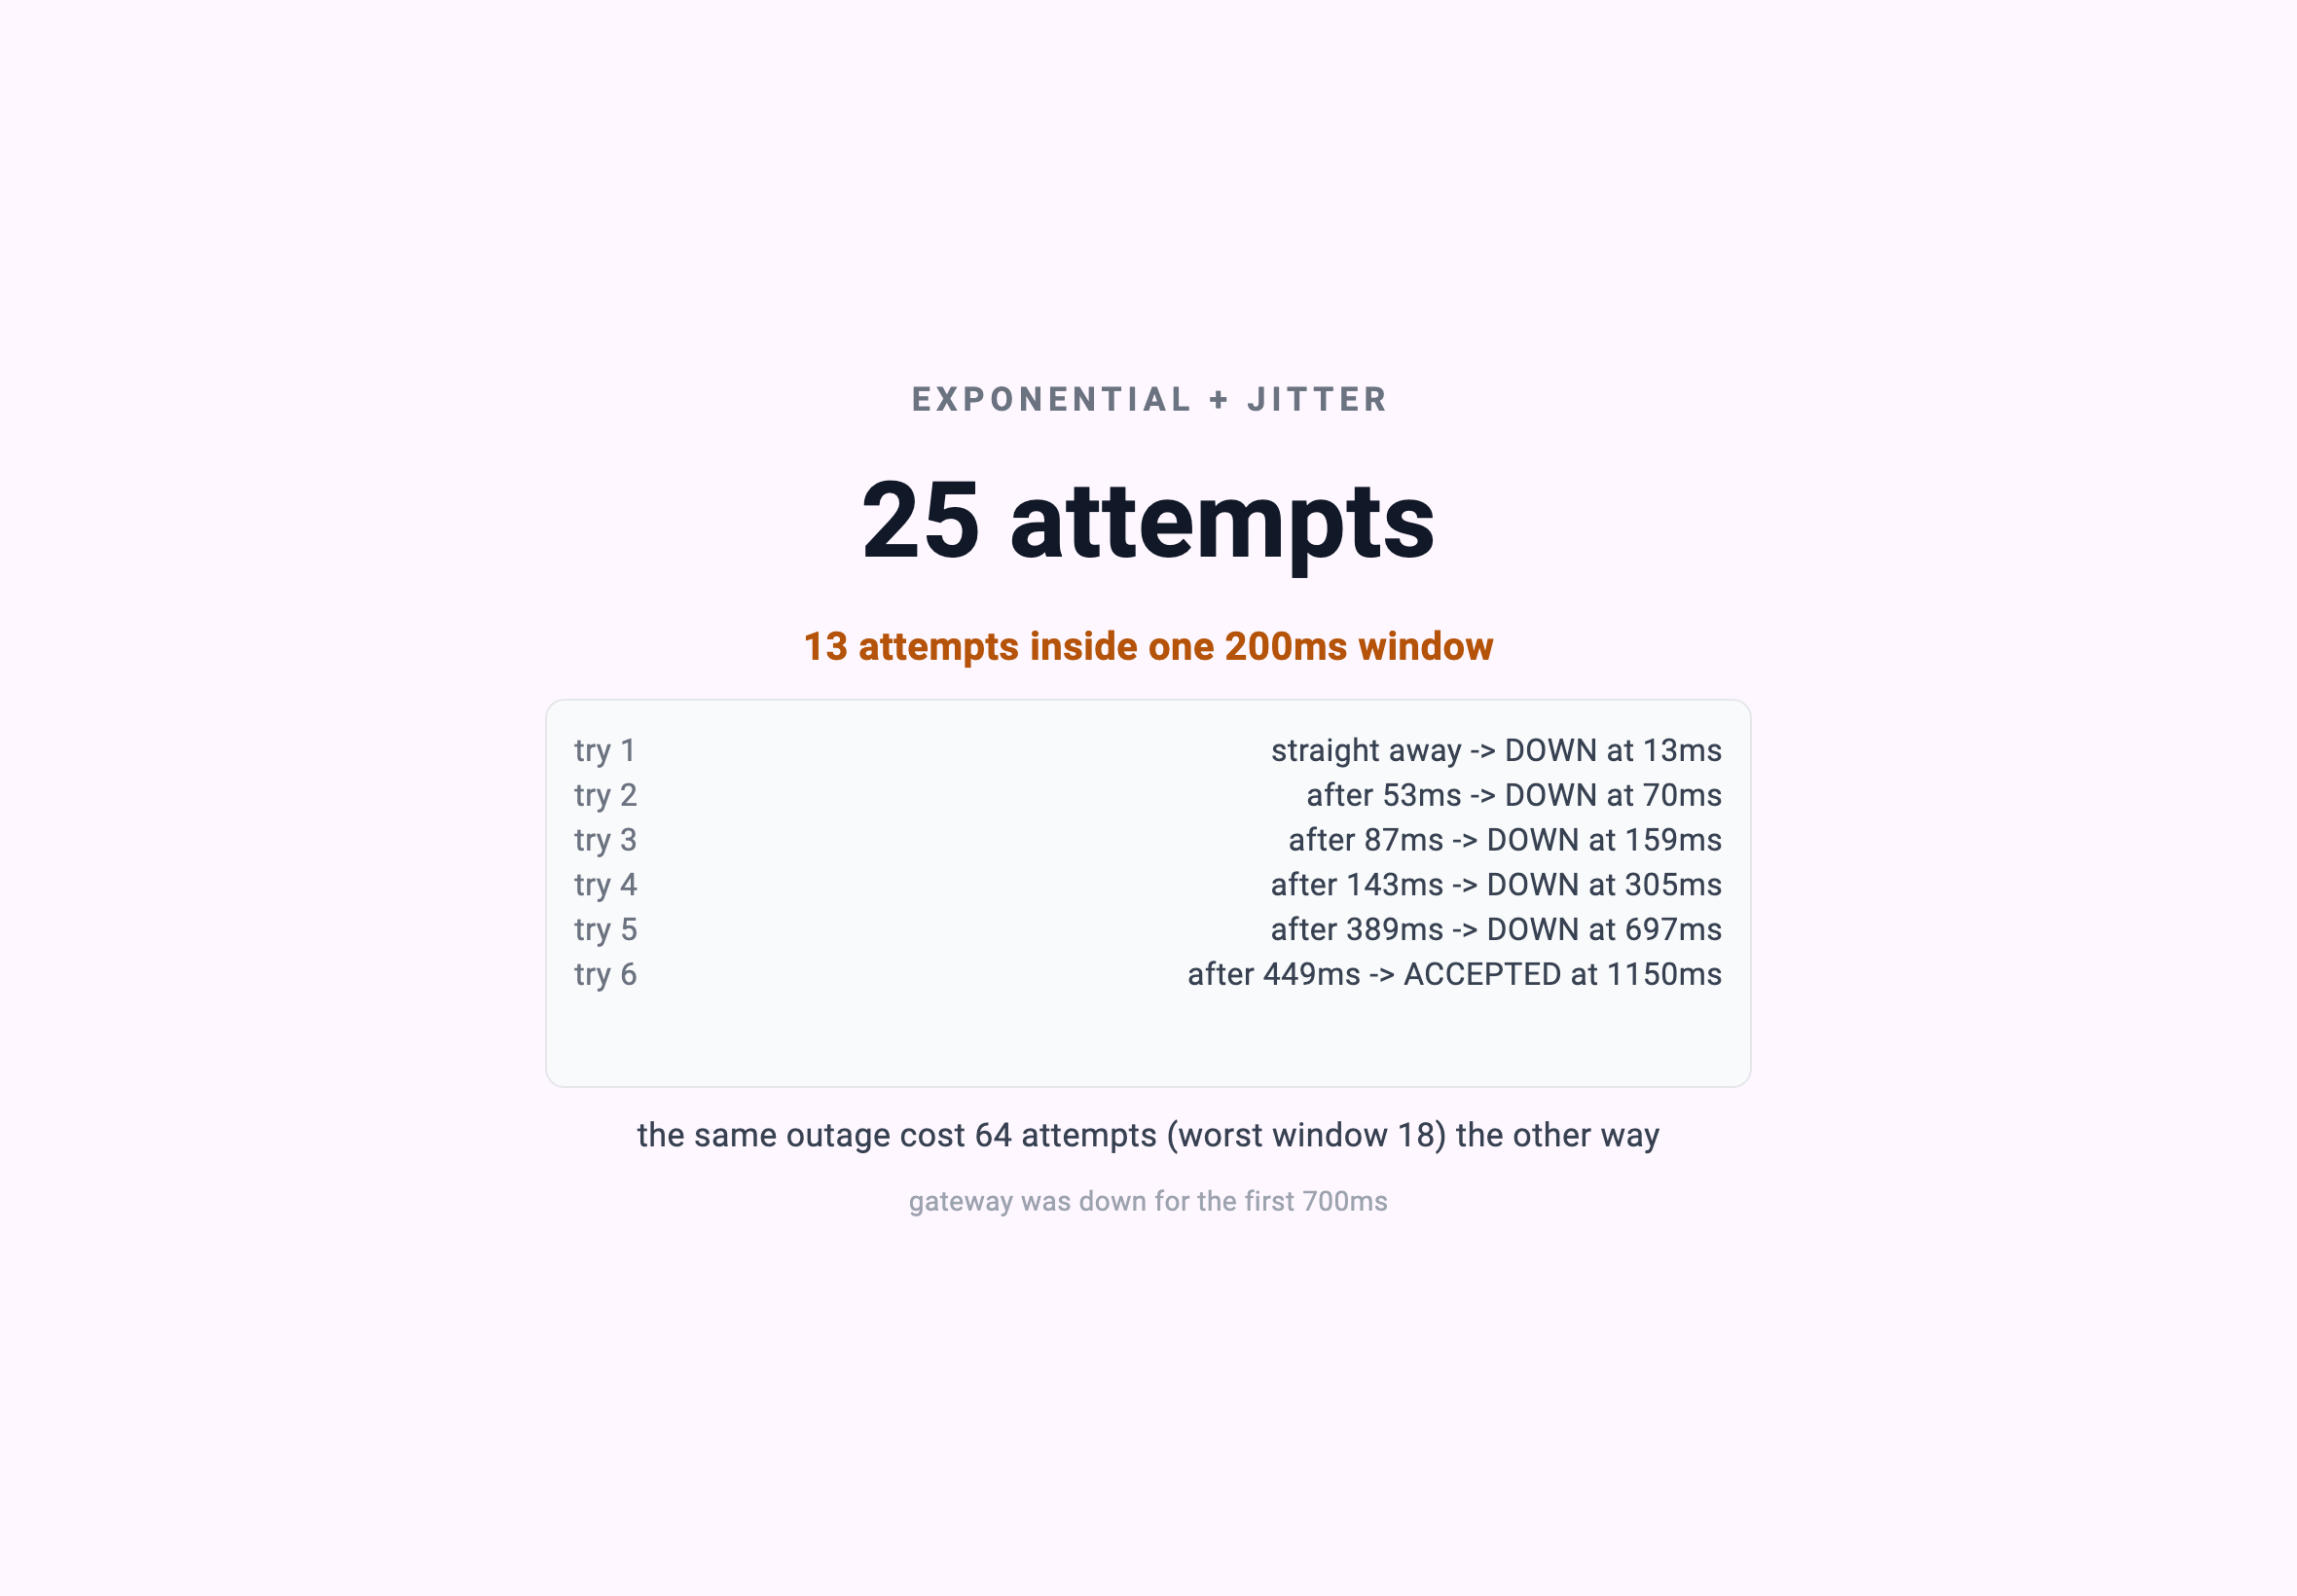
EXPONENTIAL + JITTER: 4 callers, 25 attempts total, 4 accepted, peak 13
  caller 1 attempt 1: straight away -> DOWN at 13ms
  caller 1 attempt 2: after 53ms  -> DOWN at 70ms
  caller 1 attempt 3: after 87ms  -> DOWN at 159ms
  caller 1 attempt 4: after 143ms -> DOWN at 305ms
  caller 1 attempt 5: after 389ms -> DOWN at 697ms
  caller 1 attempt 6: after 449ms -> ACCEPTED at 1150ms
同じ障害、同じ人数、同じ結果。 四人とも決済された。
試行は64回から25回。 2.6倍少ない。
倍に伸ばすことと揺らすことは別の仕事だ
ここがこの編の言いたいことだ。
指数バックオフは誰もが知っている — 60、120、240、480。ジッターはよく抜ける。 ところが呼ぶ側がひとつならジッターはあってもなくても同じで、複数ならジッターがすべてだ。
理由は単純だ。四人が同じ瞬間に失敗したなら、ジッターがなければ四人は同じ瞬間に戻ってくる。 60ms後に四人、180ms後に四人、420ms後に四人。ゲートウェイはたった今自分を倒したその山を叩かれ続ける。
上のログを見ると待ちは53、87、143、389、449で、どれも60・120・240・480ではない。 揺らされた値だ。
検証がそれを確認する。
# Backing off must actually cost the gateway less, otherwise the whole point
# is lost: everybody still gets through, but fewer of them arrive at once.
assert polite["attempts"] < hammer["attempts"], (polite["attempts"], hammer["attempts"])
assert polite["peak"] < hammer["peak"], (polite["peak"], hammer["peak"])
両方が通ったことも検査する
これがなければ検査が嘘をつく。バックオフが負荷を減らす最も簡単な方法は諦めることだからだ。
echo "$HAMMER" | grep -q "4 accepted" || { echo "   hammering did not get everybody through"; exit 1; }
echo "$POLITE" | grep -q "4 accepted" || { echo "   backoff did not get everybody through"; exit 1; }
そのうえではじめて負荷を比べる。
   attempts 64 -> 25
   peak in one 200ms window 18 -> 13
   same outage, both got through · 64 -> 25 attempts · spike 18 -> 13
総量と山を両方見る。 総量だけでは「ただゆっくりやったから減った」と区別がつかず、山が減ってはじめてゲートウェイの側が実際に楽になったことになる。
画面が緑で嘘をつきかけた
作りながら出てきたものだ。
最初は画面の下に判定の文を入れていた。「ゲートウェイが呼ぶ人数より強く叩かれた」という警告なのに、それが緑でレンダーされた。
色は状態によって変わるようにしてあったのに、その文の色だけが画面定義に #166534 で埋め込まれていた。 ログは正確で、ピクセルだけが間違っていた。
答えの横に根拠を付けるで捕まえたのと同じ種類の欠陥がまた出た。 あのときも根拠0件の答えが緑だった。
直しながら判定そのものを外した。
// The screen reports what was counted. It does not grade it — the
// comparison is the article's job, and a screen that grades tends to
// grade in a colour that disagrees with its own sentence.
画面は数えたものを言い、比較は記事がやる。 判定する画面は判定と色が食い違いやすく、食い違えば色が勝つ。
このサンプルの範囲
山の差は大きくない(18 → 13)。 総試行は2.6倍減ったのに山は1.4倍だ。理由がある — stdio転送がリクエストを直列化するので四人が本当に同じ瞬間に到着できない。どちらにも「予約されました」で出会ったのと同じ制約だ。実際のHTTPゲートウェイならこの差ははるかに大きいはずで、このサンプルはそれを見せていない。
負荷が障害を長くしない。 このゲートウェイは700ミリ秒後に無条件で復活する。実際には叩くほど遅く復活し、その帰還がこの問題を本当の問題にする部分なのに、モデルにない。
サーキットブレーカーがない。 失敗が続けばいっそ試行を止め、しばらく後に一度だけ様子を見るのが次の段階であり、作っていない。
冪等性はすでに別の編にある。 リトライが安全であるためには同じリクエストが二度入ってもよくなければならず、それはレジがない間が扱った部分だ。この編だけ読んでリトライを付ければ二重決済が起きる。
四人がすべてだ。 実際のスパイクは数千だ。桁が違えば別の話になる。
残るもの
リトライは付けるのが簡単だ。一行あればいい。
そしてその一行が他人の障害を長くする。 短く落ちるはずのサービスを落ちたままにさせるのは、たいていそのサービスを使う側のリトライループだ。
待つ時間を伸ばすことと互いに違うように待つことは別の仕事であり、多数がぶら下がるシステムでは後者のほうが重要だ。
一行多く書く代金としては安い。
練習課題
同じ予約を続けて二回送ってください。二回目で予約がもうひとつ作られないことを示し、どちら側がそれを保証したかを説明してください。