重试的代价由谁来付 — 不是打电话的那一方,是接电话的那一方
7 分钟在收银台不在的时候结尾我们写过这样一段。
没有自动重试。 是测试装置显式重连的。真实应用应该在后台周期性尝试,而那个周期和退避在这里没有定。
这一篇把那个周期定下来。而且顺便量一量,周期定错了会发生什么。
从接收方来数
关于重试的文章绝大多数是调用方的故事 — 我怎么才能把请求送进去。
这个样例的服务器站在另一边。它数的是来了多少次尝试,以及其中有多少次挤在同一个 200 毫秒里。
/// That second number is the one that matters. A gateway that is briefly down
/// does not care that you tried again. It cares how many of you tried again at
/// the same instant, because that is what keeps it down.一个短暂宕机的网关,对**「你又打了一次」这个事实不感兴趣。它在意的是有多少人在同一瞬间又打了一次。** 因为那才是让它一直躺着的东西。
赶时间时写出来的东西
/// Try again immediately. This is what gets written when the retry is added in
/// a hurry, and it is the strategy that turns a short outage into a long one.
class NoBackoff extends Backoff {
  @override
  int waitBefore(int n) => n == 1 ? 0 : 20;
}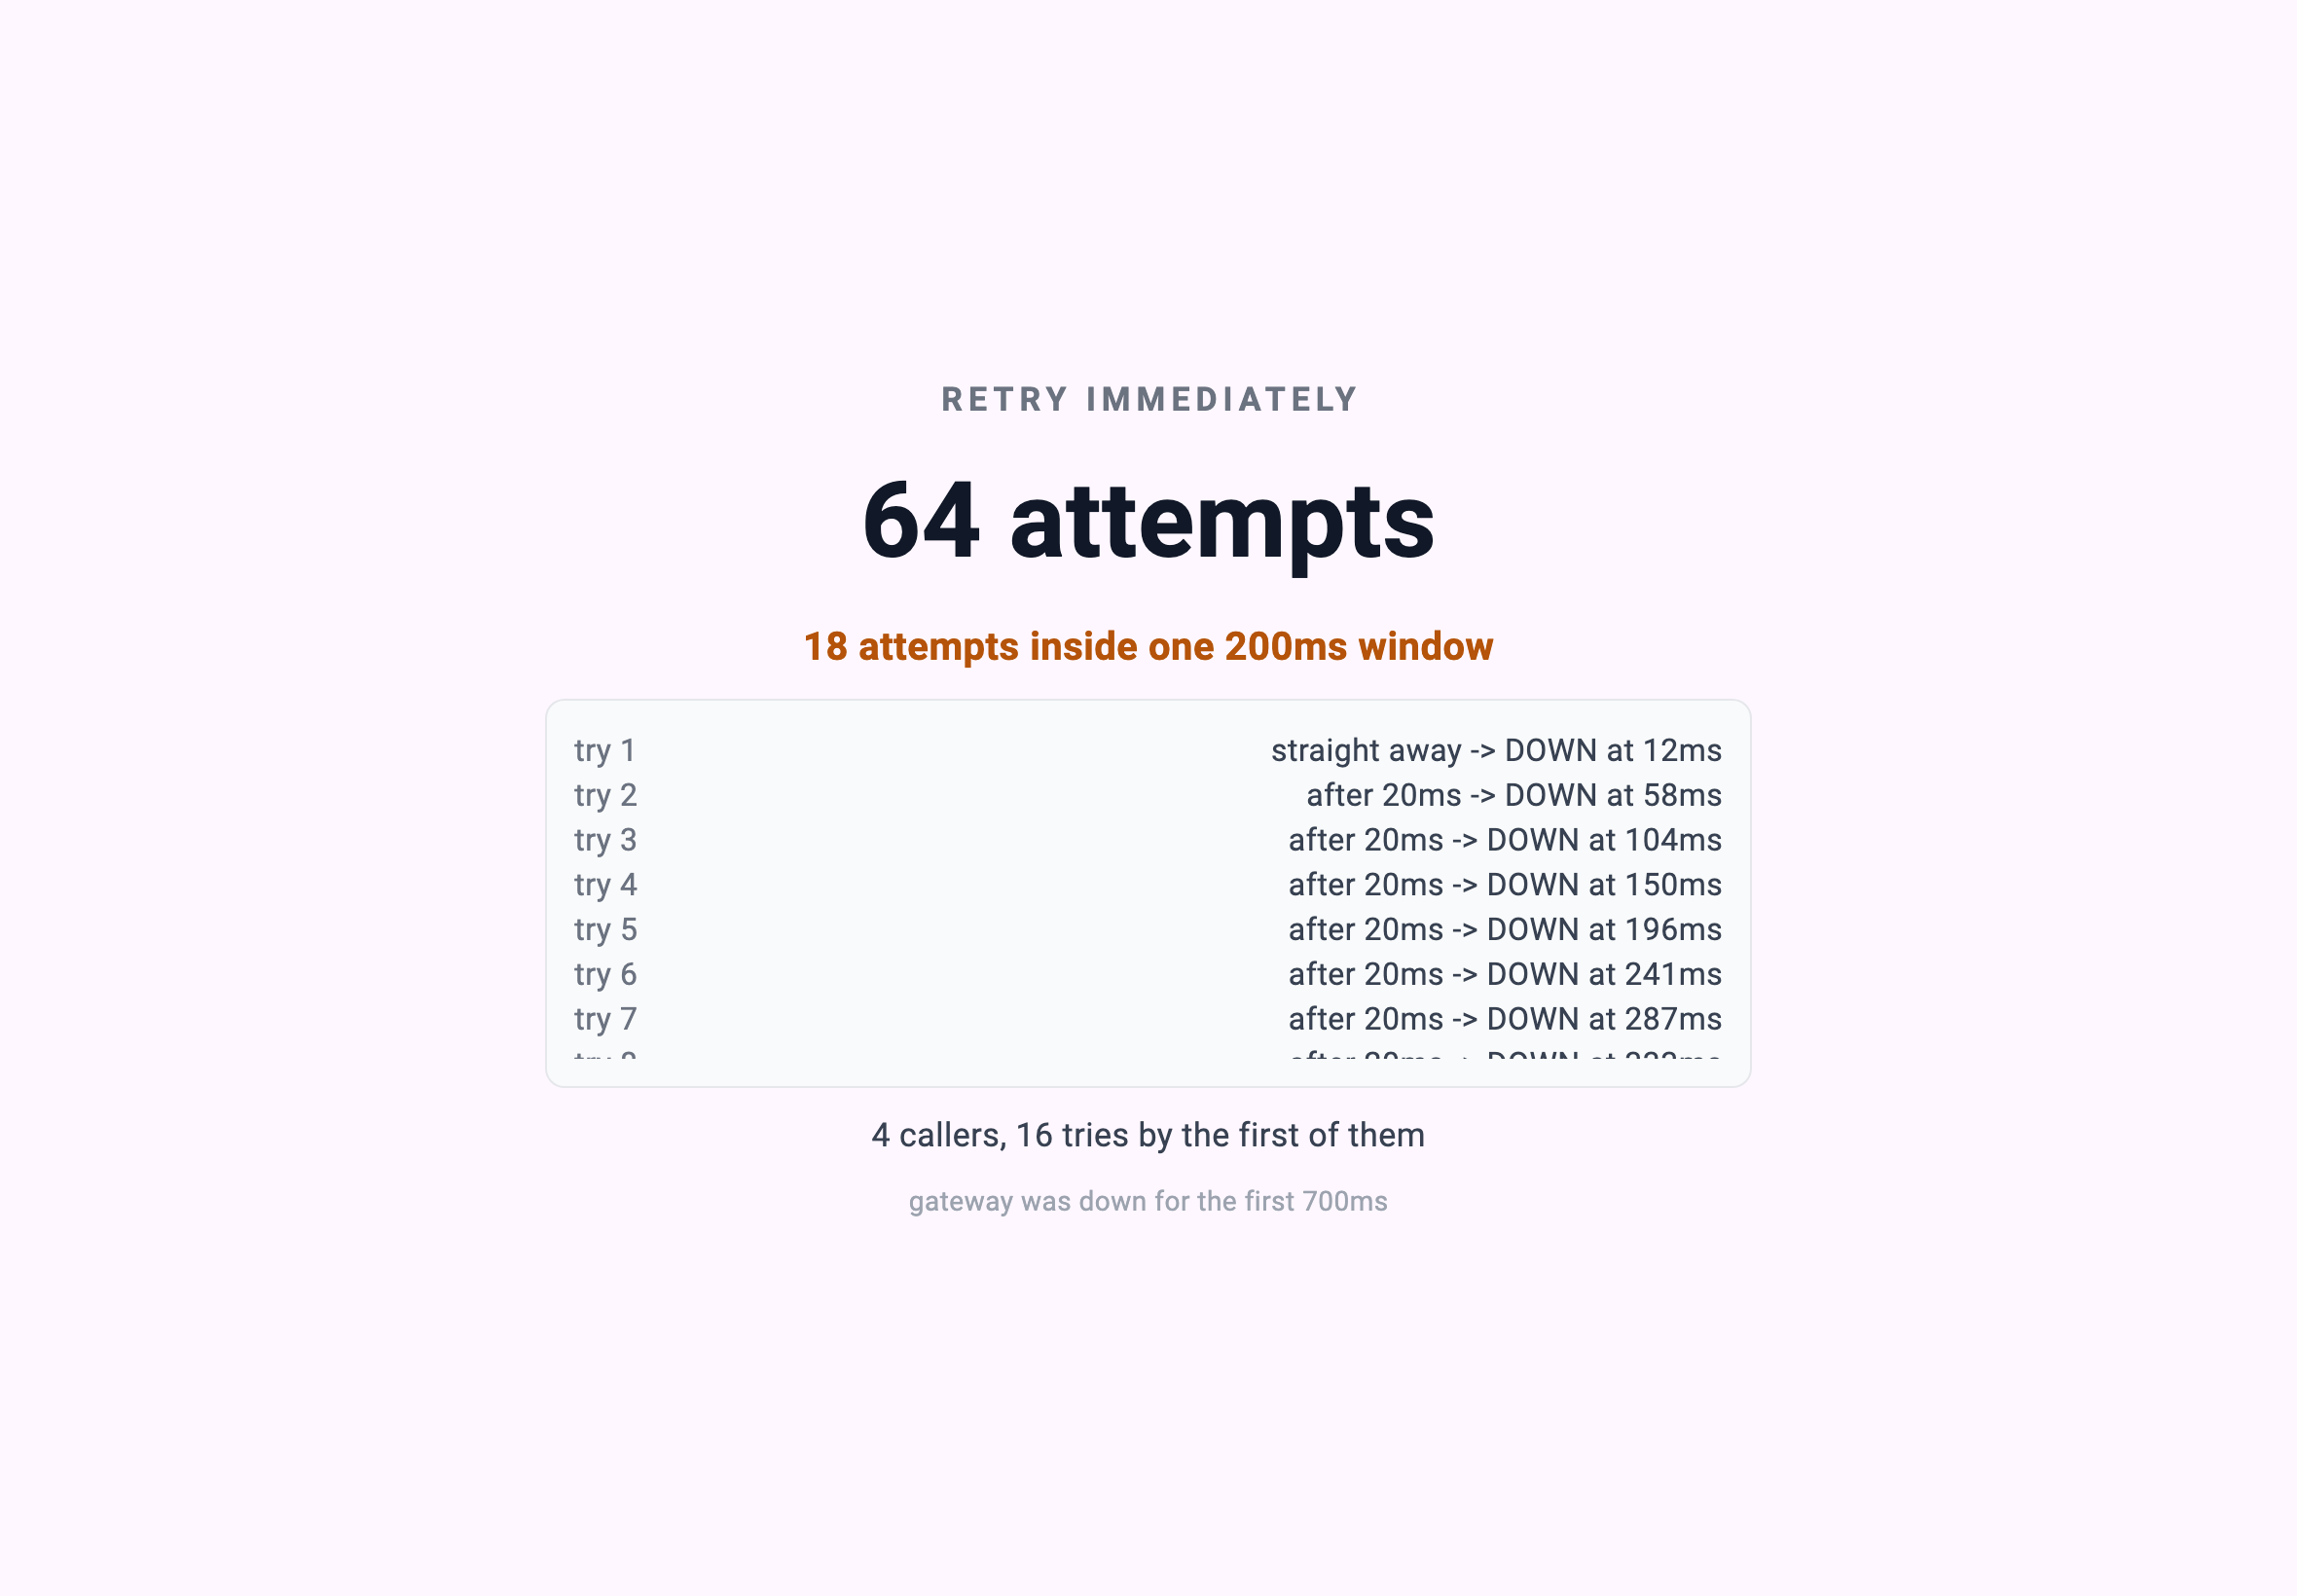
RETRY IMMEDIATELY: 4 callers, 64 attempts total, 4 accepted, peak 18
  caller 1 attempt 1: straight away -> DOWN at 12ms
  caller 1 attempt 2: after 20ms -> DOWN at 58ms
  ...
  caller 1 attempt 16: after 20ms -> ACCEPTED at 708ms
通过了。 熬过了 700 毫秒的故障,四个人都完成了支付。
而网关在这期间被砸了 64 次。
每次翻倍,然后再抖一抖
@override
int waitBefore(int n) {
  if (n == 1) return 0;
  final base = 60 * (1 << (n - 2)); // 60, 120, 240, 480 ...
  // Full jitter: anywhere in [0, base]. Spreading matters more than being
  // punctual — nobody is waiting on an exact millisecond here.
  return _rng.nextInt(base + 1);
}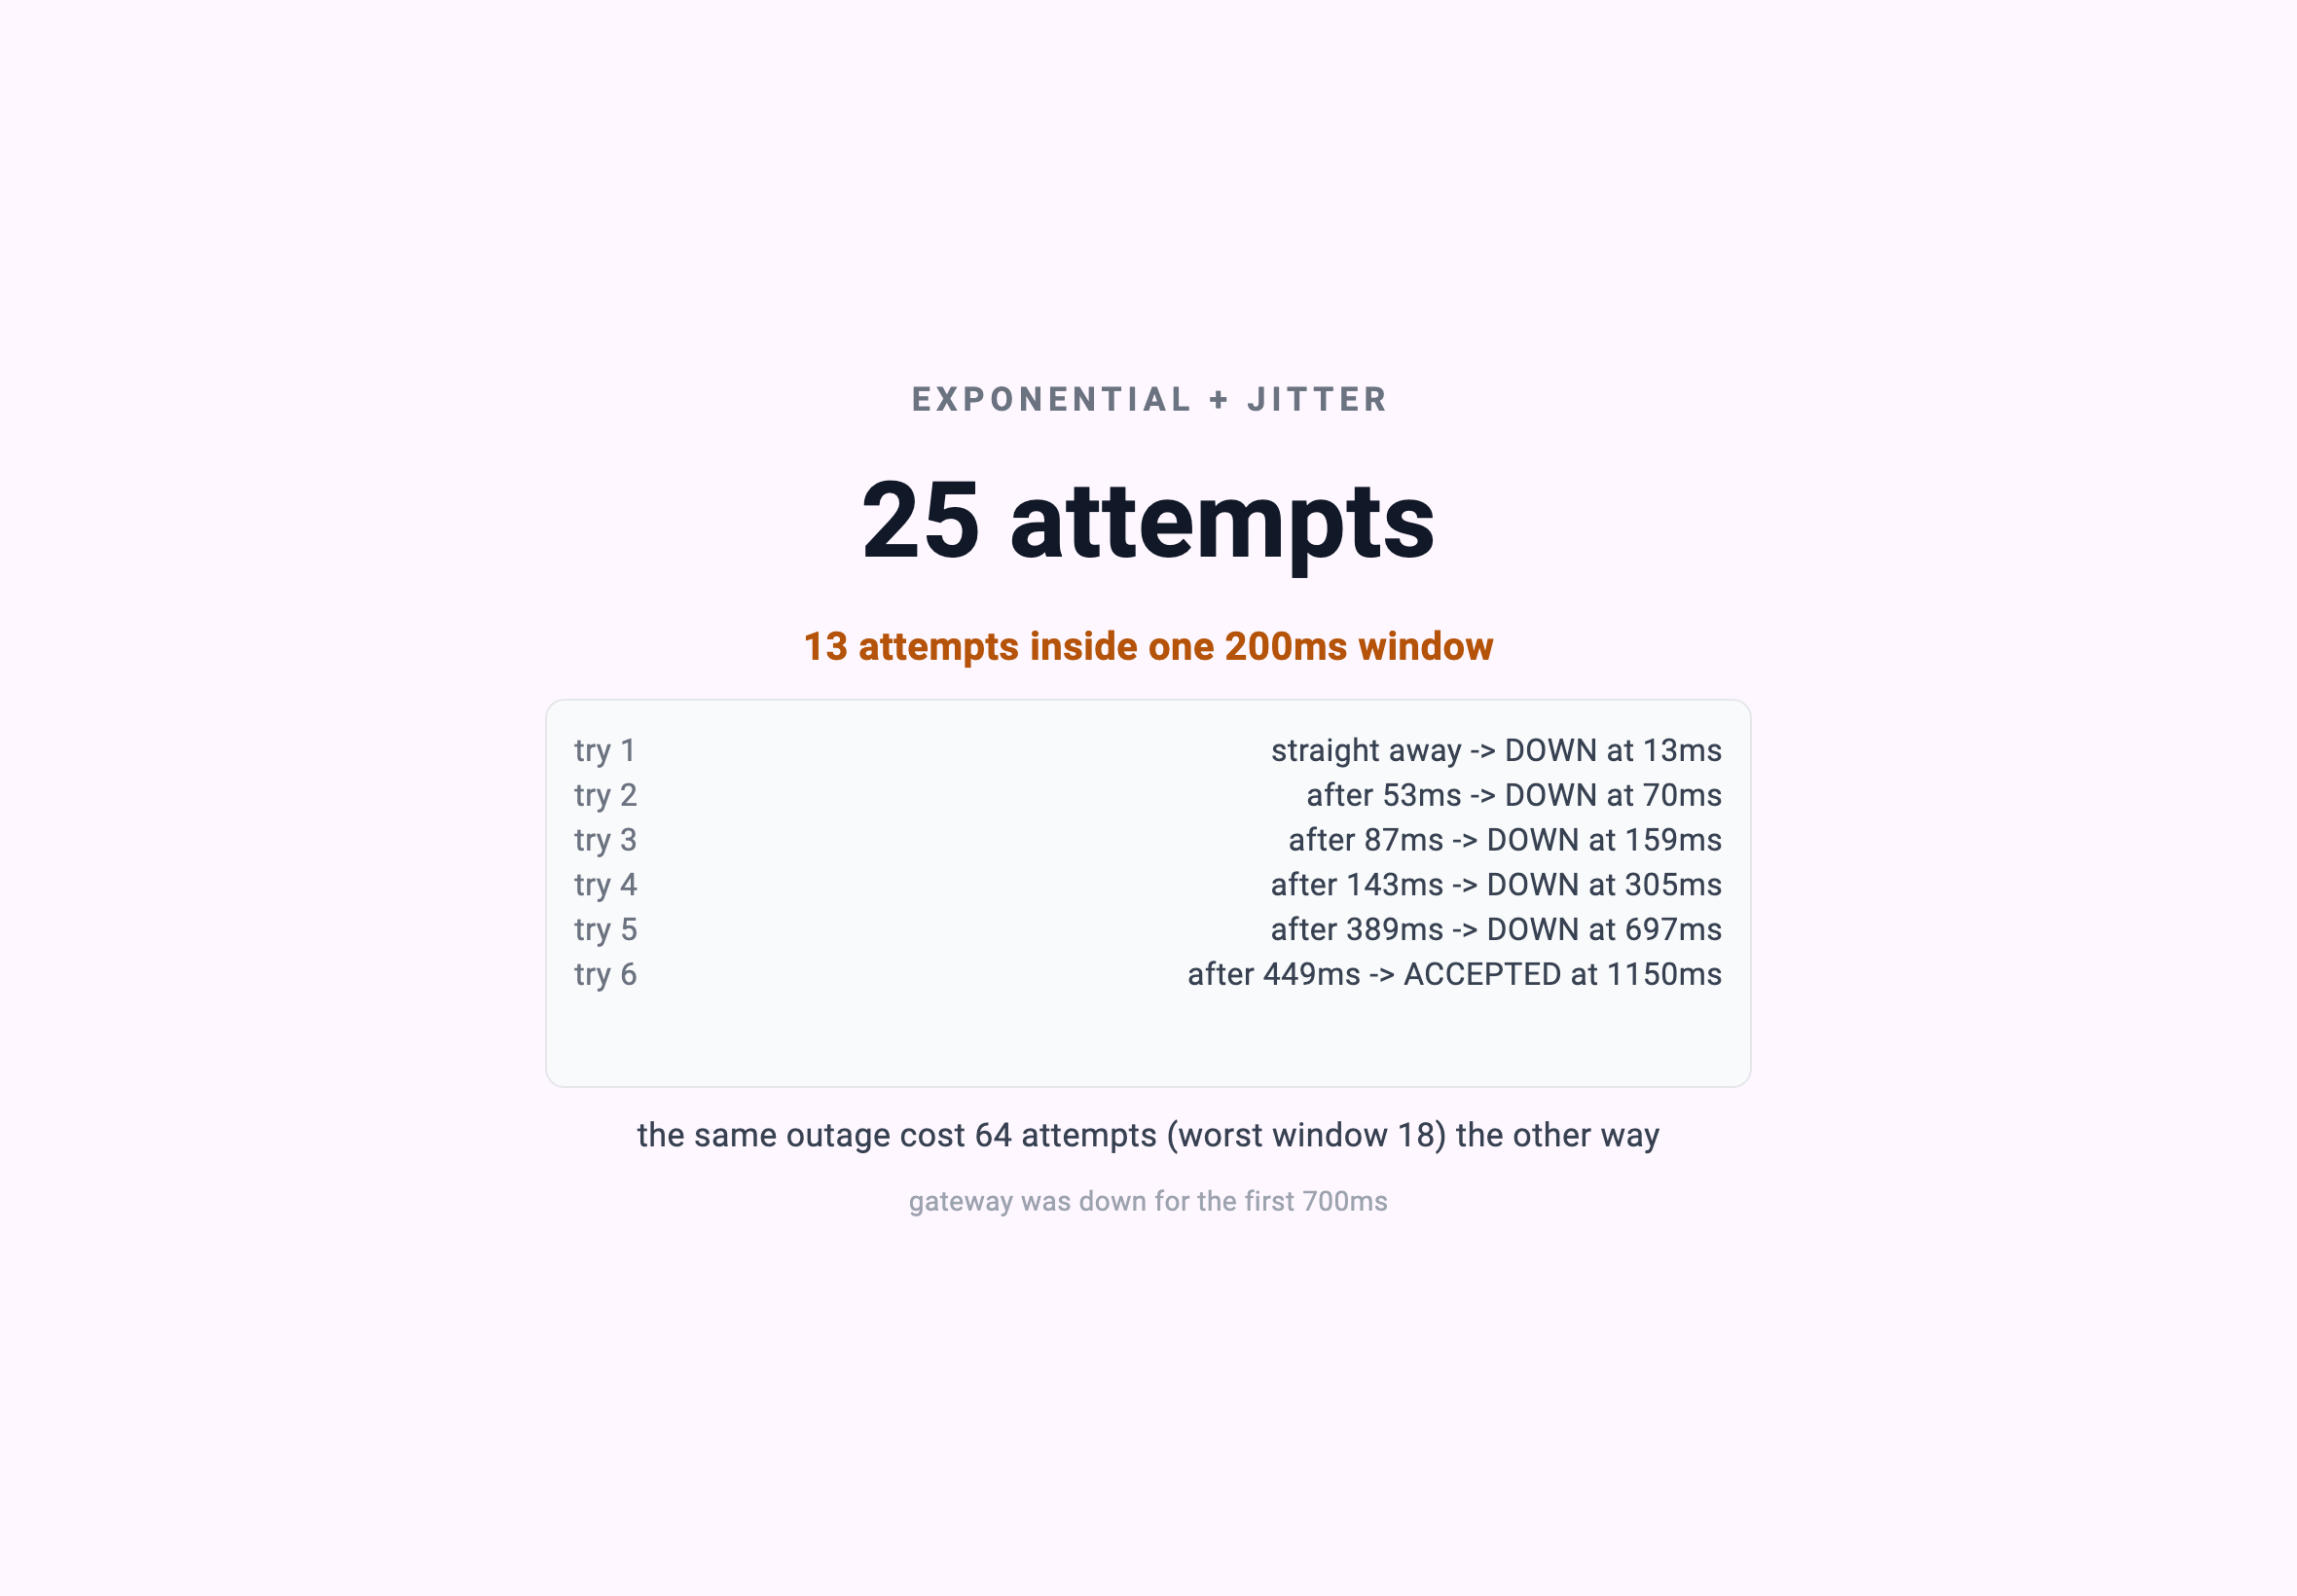
EXPONENTIAL + JITTER: 4 callers, 25 attempts total, 4 accepted, peak 13
  caller 1 attempt 1: straight away -> DOWN at 13ms
  caller 1 attempt 2: after 53ms  -> DOWN at 70ms
  caller 1 attempt 3: after 87ms  -> DOWN at 159ms
  caller 1 attempt 4: after 143ms -> DOWN at 305ms
  caller 1 attempt 5: after 389ms -> DOWN at 697ms
  caller 1 attempt 6: after 449ms -> ACCEPTED at 1150ms
同样的故障、同样的人数、同样的结果。 四个人都完成了支付。
尝试从 64 次降到 25 次。 少了 2.6 倍。
「翻倍」和「抖动」是两件事
这是这一篇想说的。
指数退避人人都知道 — 60、120、240、480。抖动常常被漏掉。 可是调用方只有一个时,抖动有没有都一样;有好几个时,抖动就是全部。
理由很简单。如果四个人在同一瞬间失败了,没有抖动,四个人就会在同一瞬间回来。 60ms 后四个、180ms 后四个、420ms 后四个。网关会一次次挨着刚刚把它撂倒的那座山峰。
看上面的日志,等待是 53、87、143、389、449 —没有一个是 60、120、240、480。 都是被抖过的值。
验证会确认这一点。
# Backing off must actually cost the gateway less, otherwise the whole point
# is lost: everybody still gets through, but fewer of them arrive at once.
assert polite["attempts"] < hammer["attempts"], (polite["attempts"], hammer["attempts"])
assert polite["peak"] < hammer["peak"], (polite["peak"], hammer["peak"])
也检查两边都通过了
没有这一条,检查就会撒谎。因为退避降低负载最简单的办法就是放弃。
echo "$HAMMER" | grep -q "4 accepted" || { echo "   hammering did not get everybody through"; exit 1; }
echo "$POLITE" | grep -q "4 accepted" || { echo "   backoff did not get everybody through"; exit 1; }
在那之后才去比负载。
   attempts 64 -> 25
   peak in one 200ms window 18 -> 13
   same outage, both got through · 64 -> 25 attempts · spike 18 -> 13
总量和峰值都要看。 只看总量,就分不清它和「只是变慢了所以少了」;峰值降下来,网关那边才是真的轻松了。
画面差点用绿色撒谎
这是做的过程中冒出来的。
一开始画面底部有一句判定。那是条警告 —「网关挨的次数超过了调用者的人数」— 而它渲染成了绿色。
颜色本来是随状态变的,可偏偏那句话的颜色在画面定义里被写死成 #166534。日志是准确的,只有像素错了。
和把依据放在答案旁边里抓到的同一类缺陷又出现了。 那次也是依据为 0 的回答显示成绿色。
修的时候,我们把判定本身拿掉了。
// The screen reports what was counted. It does not grade it — the
// comparison is the article's job, and a screen that grades tends to
// grade in a colour that disagrees with its own sentence.
画面说它数到了什么,比较交给文章去做。 会下判定的画面,容易和自己的颜色对不上;一旦对不上,赢的是颜色。
这个样例的范围
峰值的差距不大(18 → 13)。 总尝试少了 2.6 倍,峰值只降了 1.4 倍。这是有原因的 —stdio 传输把请求串行化了,四个人根本没法真的在同一瞬间到达。这和两个人都收到「已预订」里遇到的是同一个约束。换成真实的 HTTP 网关,这个差距会大得多,而这个样例没有展示出来。
负载不会让故障变长。 这个网关无论如何都会在 700 毫秒后复活。现实中砸得越狠恢复得越晚,而那个反馈才是让这个问题成为真问题的部分 — 模型里没有。
没有熔断器。 连续失败之后干脆停止尝试、过一阵再探一次,那是下一步,而我们没有做。
幂等性已经在另一篇里了。 重试要安全,同一个请求就必须允许进来两次,那正是收银台不在的时候处理的部分。只读这一篇就去加重试,会出现重复扣款。
四个人就是全部。 真实的尖峰是数千。量级不同,就是另一个故事了。
剩下的
重试很容易加。一行就够。
而那一行会让别人的故障变长。 让一个本该短暂宕机的服务一直躺着的,通常正是使用它那一方的重试循环。
把等待时间拉长,和彼此错开地等待,是两件事;在很多人挂上来的系统里,后者更重要。
作为多写一行的代价,它很便宜。
练习任务
连续发送两次相同的预订。证明第二次不会再生成一个预订,并说明是哪一方保证了这一点。