拒绝阅读的工具 — 在诊疗流程里把判断放到外面
6 分钟先说明两件事。
第一,2026 年 4 月,本刊登过一篇某位医生做诊疗流程工具的文章。这个现场不是某家特定的诊所。 我们把它实际运转的形状照实构成,也不点名是哪里。以下是按那个形状自己做的,流程与数值都是编的。
第二,这篇不是医疗建议,这里做的东西也不是医疗器械。 这个系列没有做临床验证,也不在能做的位置上。它处理的是软件的一条边界 —把判断放在工具之外,在代码里长什么样。
用文字画的线会被抹掉
原文里也有那条线。「诊断留给人,只把诊疗的流程整理到画面上。」
说得对。问题是它只作为一句话存在。
作为一句话存在的线会被抹掉。而且是以这种方式被抹掉:几个月后有人说「要是有一行摘要就方便了」,加了一个字段。那个字段里放进 大体在正常范围内 这样的字符串。没有人注意到那一刻。 那正是工具开始下诊断的那一刻。
所以这次我们把它画进了代码。画了两次。
第一条线 — 没有那样的工具
tools offered: flow.state, flow.done, readings.list只有三个。展示流程、把某一步标记为完成、把测量值原样返回。没有做判定、分类、解读的工具。
验证从工具的名字开始看。
WORDS = ["diagnos", "assess", "judg", "risk", "abnormal", "recommend"]
for n in s.tool_names():
assert not any(w in n.lower() for w in WORDS), n这是先前一篇里确认过的原理的应用。工具清单就是表面,而不在清单上的能力,人去按也好模型去选也好都够不着。
第二条线 — 听起来像判定就抛异常
光有清单不够,因为判定可能混进 flow.state 返回的字符串里。
/// Words that would turn a report into a verdict. Anything this server is
/// about to say is checked against them.
///
/// A list of words is a crude guard and it is meant to be. It cannot stop a
/// determined author, but it does stop the ordinary way this line gets
/// crossed: someone adds a helpful-sounding summary field months later and
/// nobody notices that the tool started diagnosing.
static const forbidden = [
  'diagnos', 'likely', 'suggests', 'consistent with', 'probable',
  'abnormal', 'normal', 'healthy', 'concerning', 'severe', 'mild',
  'recommend', 'should take', 'prescribe',
];

static String _guard(String s) {
  final lower = s.toLowerCase();
  for (final w in forbidden) {
    if (lower.contains(w)) {
      throw StateError('clinic_server tried to emit a judgement word: "$w"');
    }
  }
  return s;
}
这个服务器吐出的每一个字符串都要经过这个函数。 请注意 normal 在清单上 — 它是看起来最无害的词,也是最常越线的词。
这是个粗糙的守卫。铁了心的人挡不住。可这条线实际被抹掉的方式不是铁了心,而是疏忽,而疏忽靠这点东西就挡住了。
而且验证会扫描整次运行。
no judgement vocabulary in anything the server returned这个工具实际做的事
线画了两条,来看剩下的是什么。
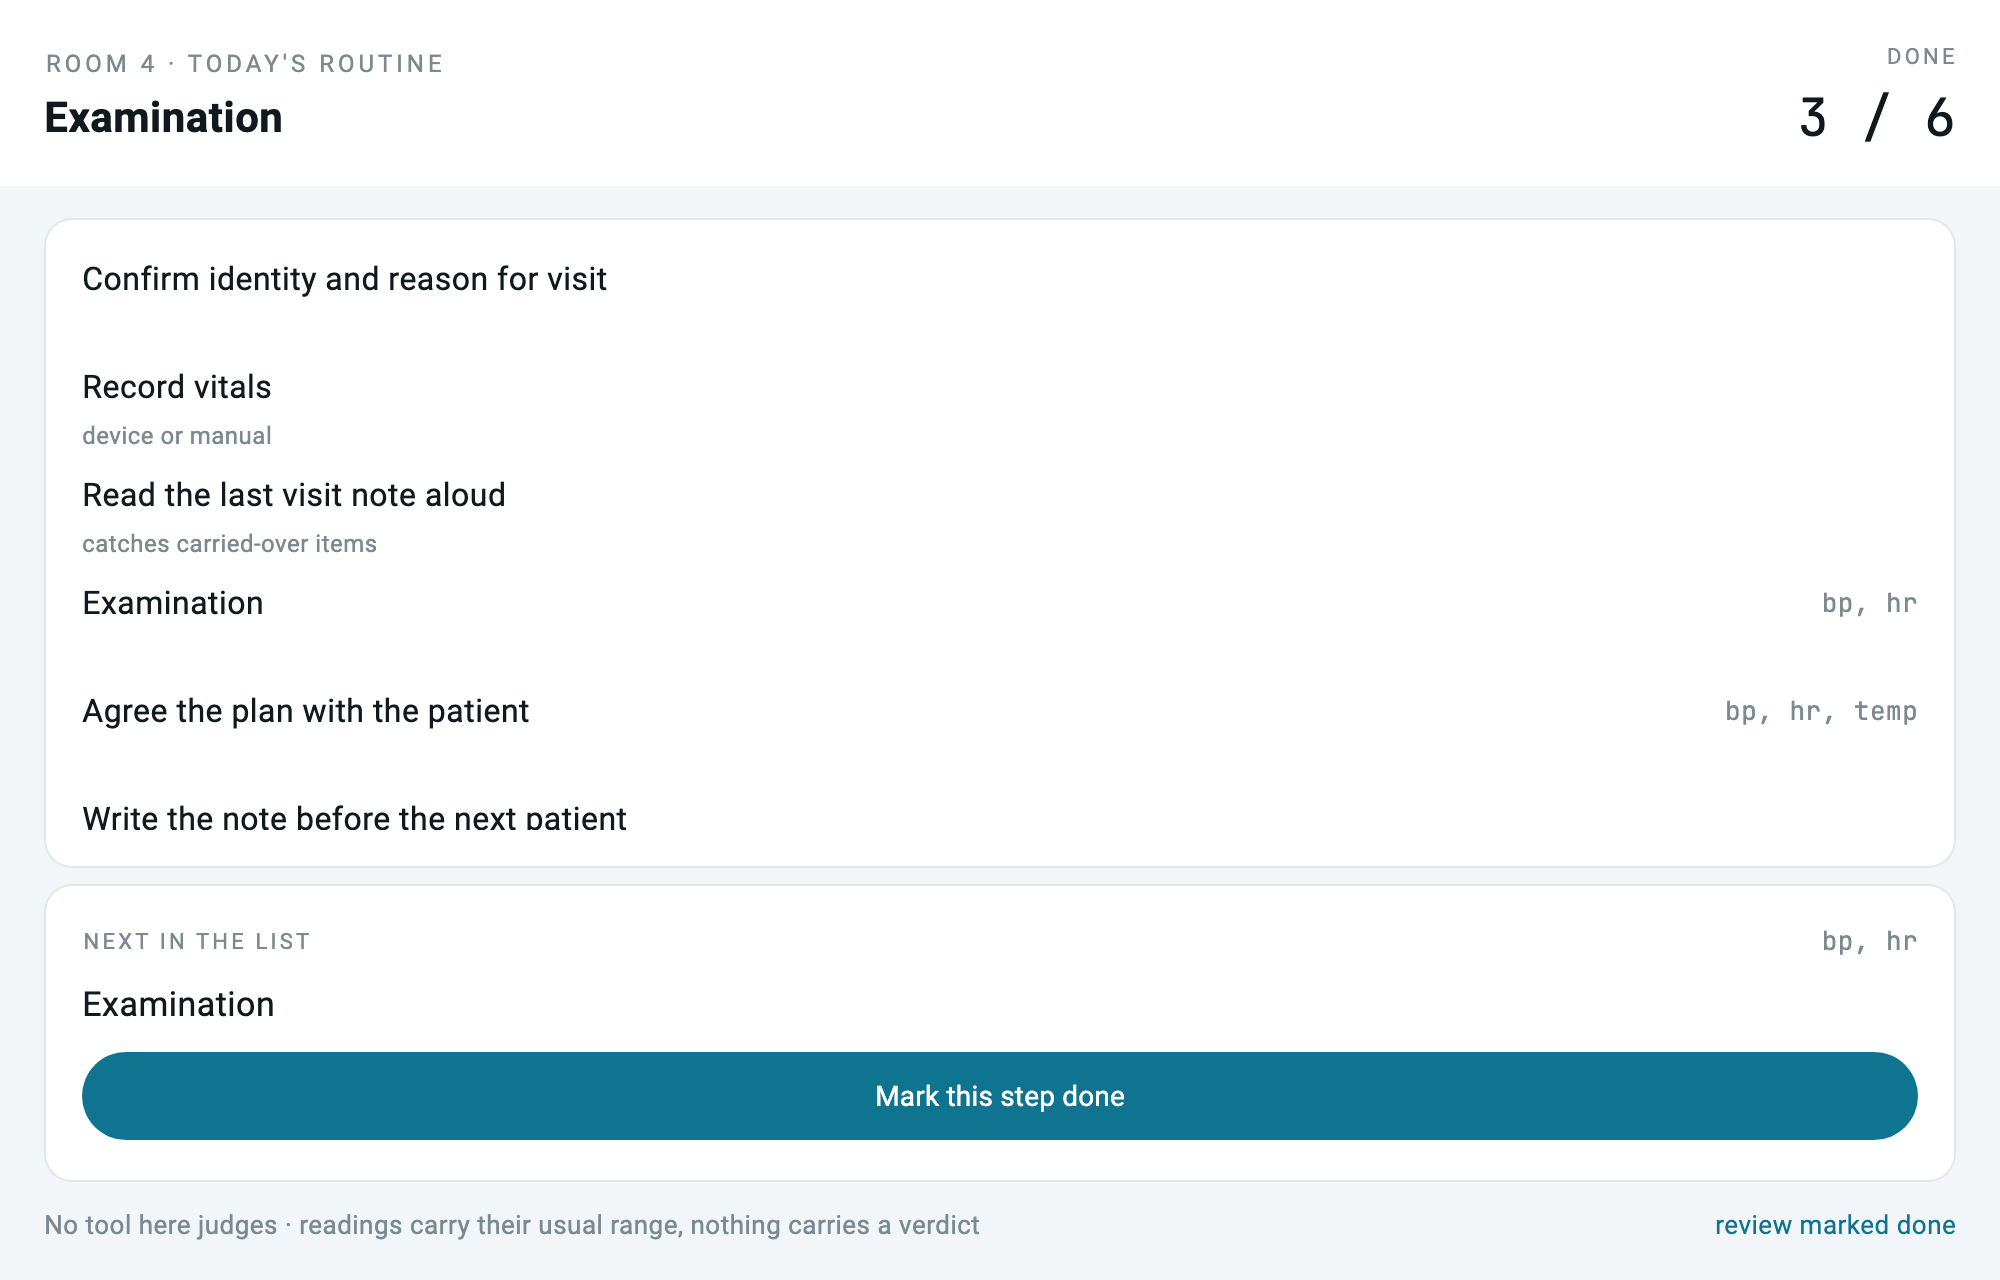
按顺序展示流程。 就是医生写的那个顺序。
routine: intake* -> vitals* -> review -> exam -> plan -> note* 是已完成的。画面最上面显示的是接下来要做的,而这也不是建议。
// "Next" is position in a list the clinician wrote. It is not advice.
'next': _guard(next.label),
它只是清单里的一个位置。 这个区分看着微不足道,但「接下来请做这个」和「在你写下的顺序里下一格是这个」,责任的位置是不同的。
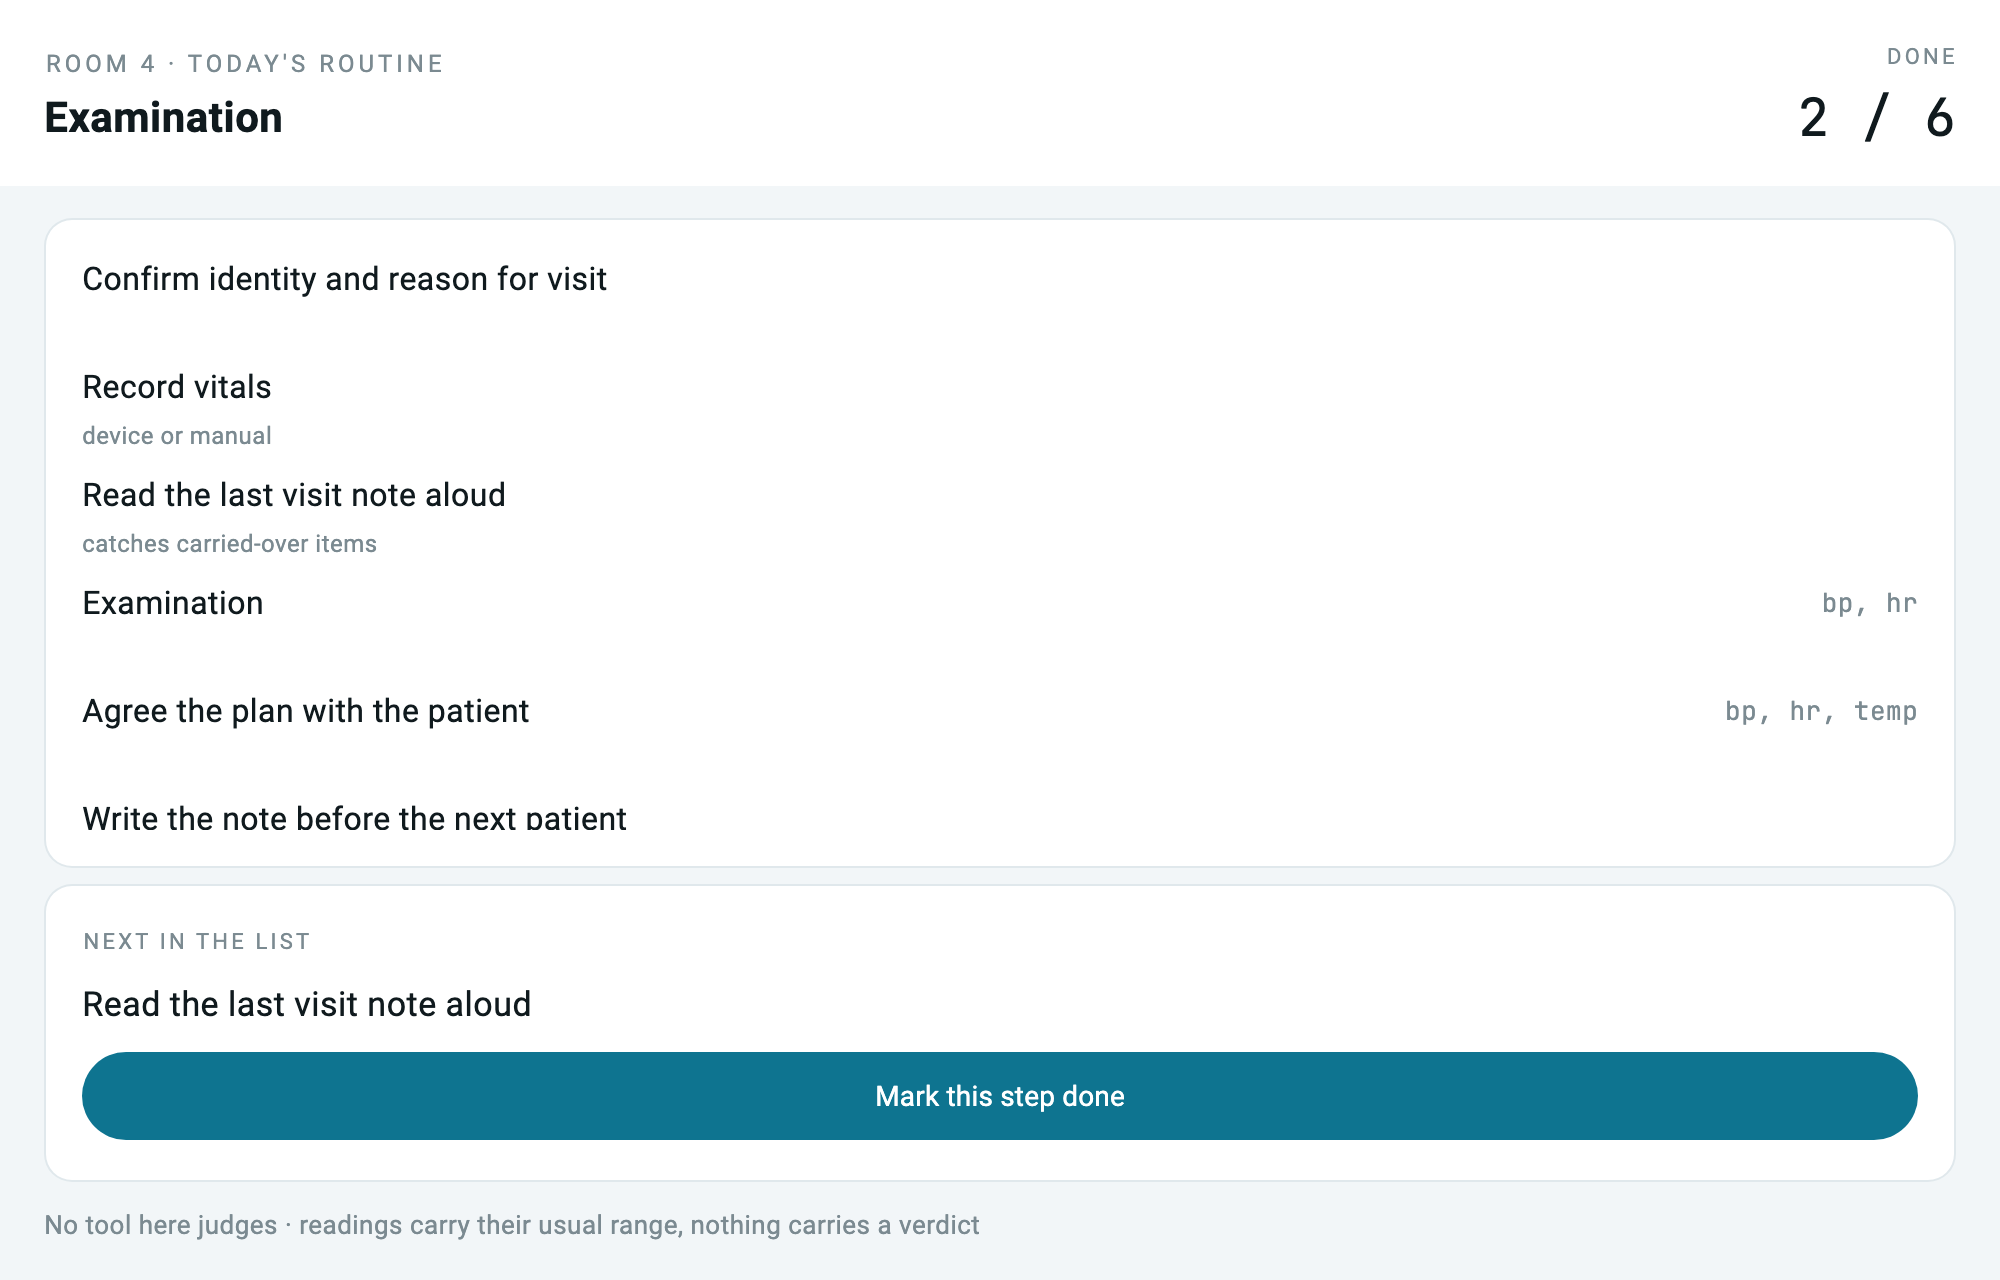
把一步标记为完成,只有位置在动。
测量值原样给出,但把参考范围挂在旁边。
readings: Blood pressure 148/92mmHg (clinic uses <130/80)
        | Heart rate 78bpm (clinic uses 60-100)
        | Temperature 36.8C (clinic uses 36.1-37.2)
148/92 旁边有 <130/80。但它不说「偏高」。 那个判断不属于这个工具。
挂上参考范围本身是有必要的。只有一个数字,读的人会自己把判定补上。 而那个判定不会被记录在任何地方。范围在旁边,至少「它是跟什么比的」留在了画面上。
验证也看这一条。
readings = s.call("readings.list")["readings"]
assert len(readings) == 3 and all(r["usual"] for r in readings)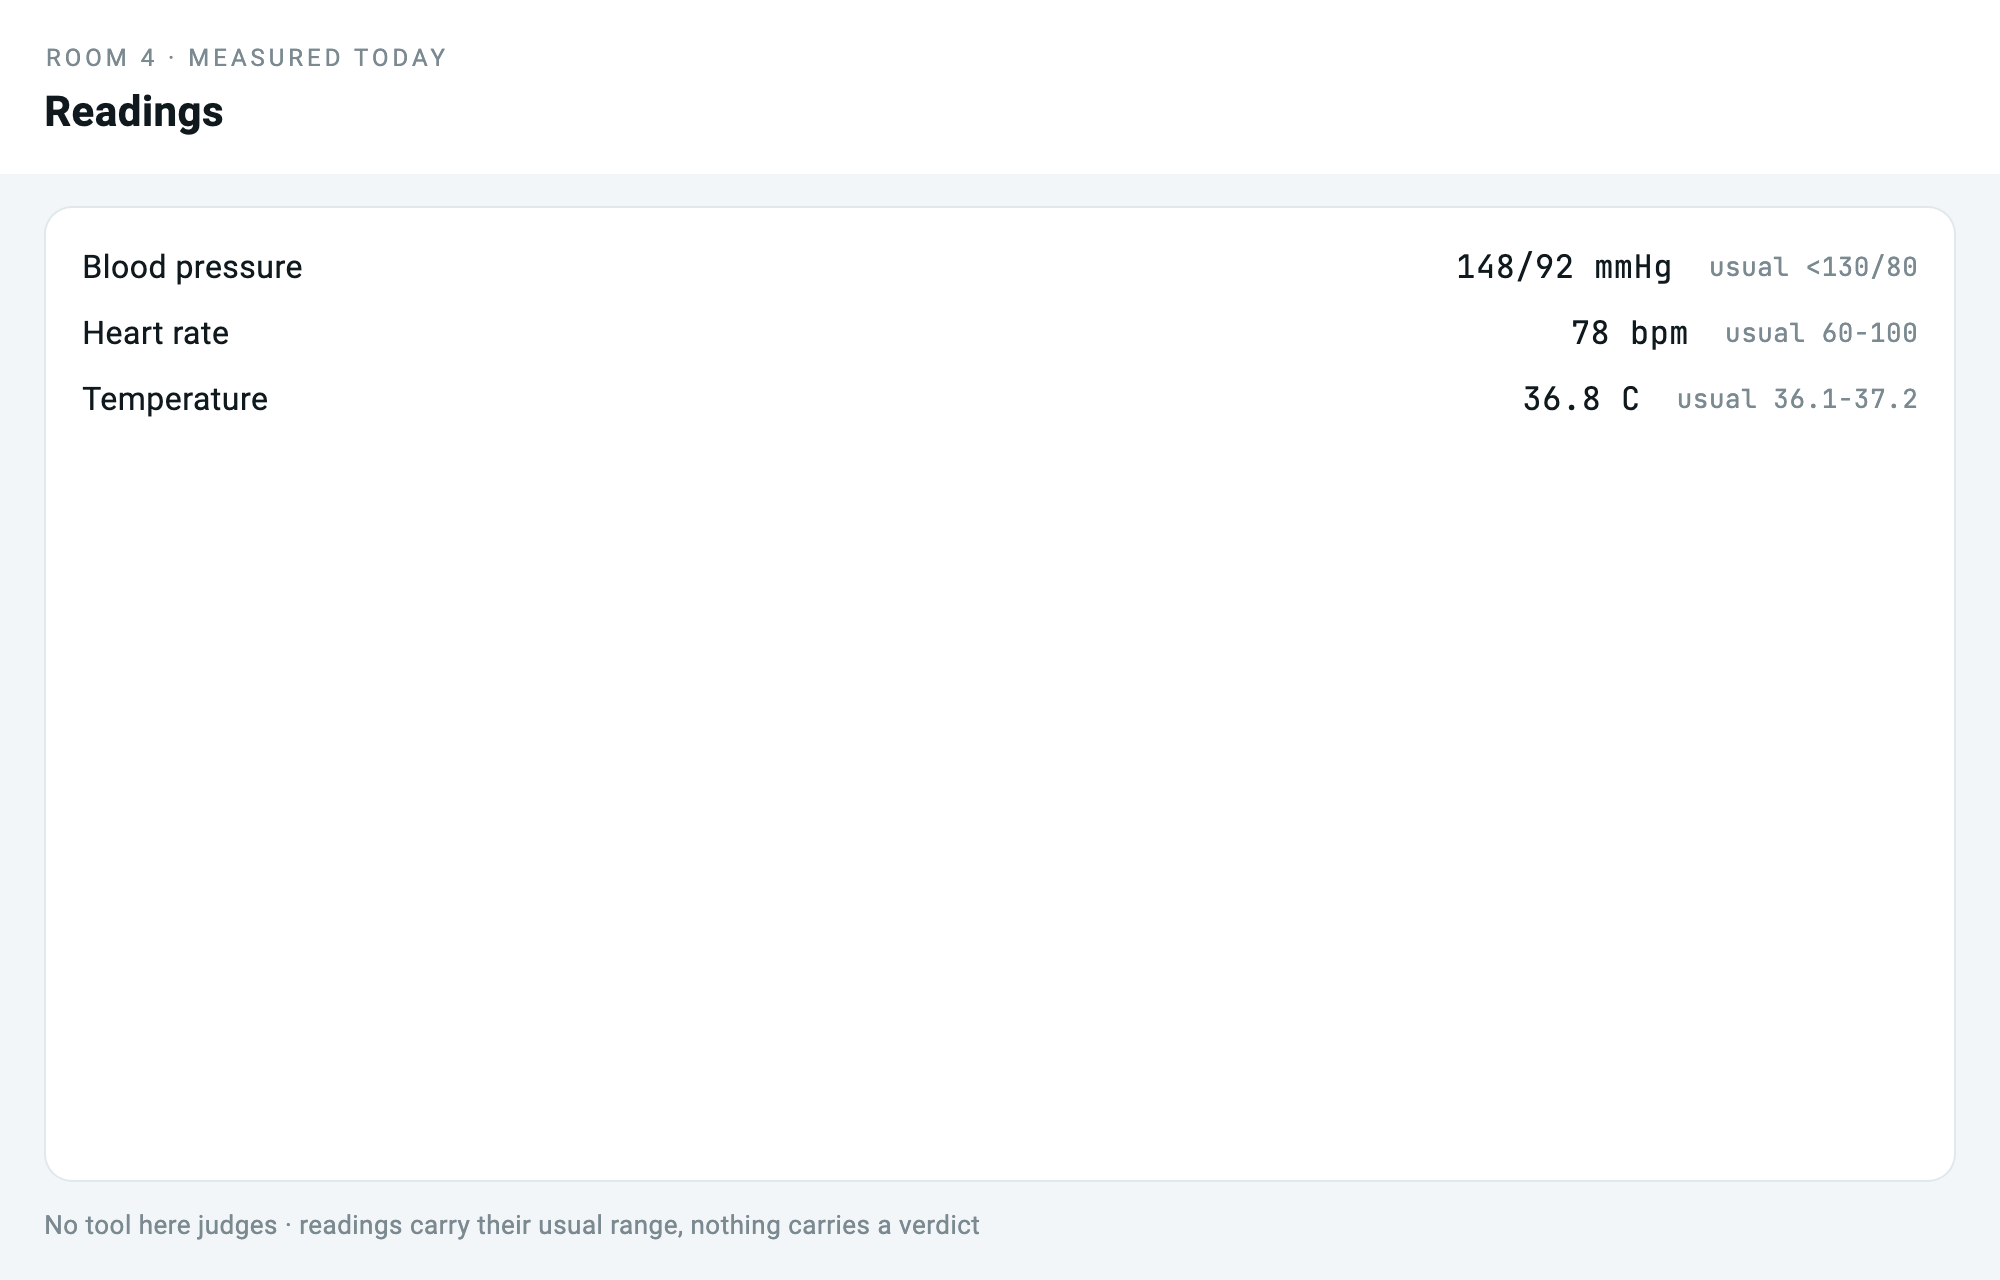
这个样例的范围
没有这位医生。 而且上面的流程和参考值都是我编的。像 clinic uses <130/80 这样的值是这个样例的数字,不是任何诊疗指南。
这篇验证的只到软件的一条性质。 就是「这个工具不产出判断」。那并不意味着它是个好的诊疗工具。 它在临床上是否有用、是否安全、是否满足监管要求,全都在这个系列之外,而我们没有做那些判断所需的验证。
医疗器械监管也没有涉及。 这类软件从哪一点起进入监管范围,各辖区不同,这篇没有去探讨那条线。
把「不做什么」写进代码
原文那句话是对的。诊断留给人。
做出来之后再加一行。那句话必须在代码里的某处,以可执行的形式存在。 只写在文档里,六个月后没人记得,而没人记得的原则不是原则。
在这个服务器里,那个形式是三样东西。
- 不存在的工具 — 清单就是表面
- 会抛异常的守卫 — 听起来像判定就抛
- 会失败的验证 — 上面两条一旦垮掉就不通过
三样都不是了不起的技术。只是三样都是代码,不是文字。 这个差别会在六个月后留下来。
练习任务
从设备示例中选一个回答,指出它引用的记录。如果没有匹配的记录,工具应该怎么做?