재시도가 무는 값 — 다시 걸어 보는 쪽 말고, 받는 쪽
7 분계산대가 없는 동안 끝에 이렇게 적었다.
자동 재시도가 없다. 하니스가 명시적으로 다시 붙였다. 실제 앱이라면 뒤에서 주기적으로 시도해야 하고, 그 주기와 backoff 는 여기서 안 정했다.
이 편이 그 주기를 정한다. 그리고 정하는 김에, 주기를 잘못 정하면 무슨 일이 생기는지를 잰다.
받는 쪽에서 센다
재시도 글은 대부분 거는 쪽 이야기다 — 어떻게 내 요청을 통과시킬까.
이 샘플의 서버는 반대편에 선다. 시도가 몇 번 왔는지, 그리고 그중 몇 번이 같은 200밀리초 안에 몰렸는지를 센다.
/// That second number is the one that matters. A gateway that is briefly down
/// does not care that you tried again. It cares how many of you tried again at
/// the same instant, because that is what keeps it down.
잠깐 죽은 게이트웨이는 당신이 다시 걸었다는 사실에 관심이 없다. 관심 있는 건 몇 명이 같은 순간에 다시 걸었는가다. 그게 계속 죽어 있게 만드는 것이기 때문이다.
급할 때 쓰는 방법
/// Try again immediately. This is what gets written when the retry is added in
/// a hurry, and it is the strategy that turns a short outage into a long one.
class NoBackoff extends Backoff {
  @override
  int waitBefore(int n) => n == 1 ? 0 : 20;
}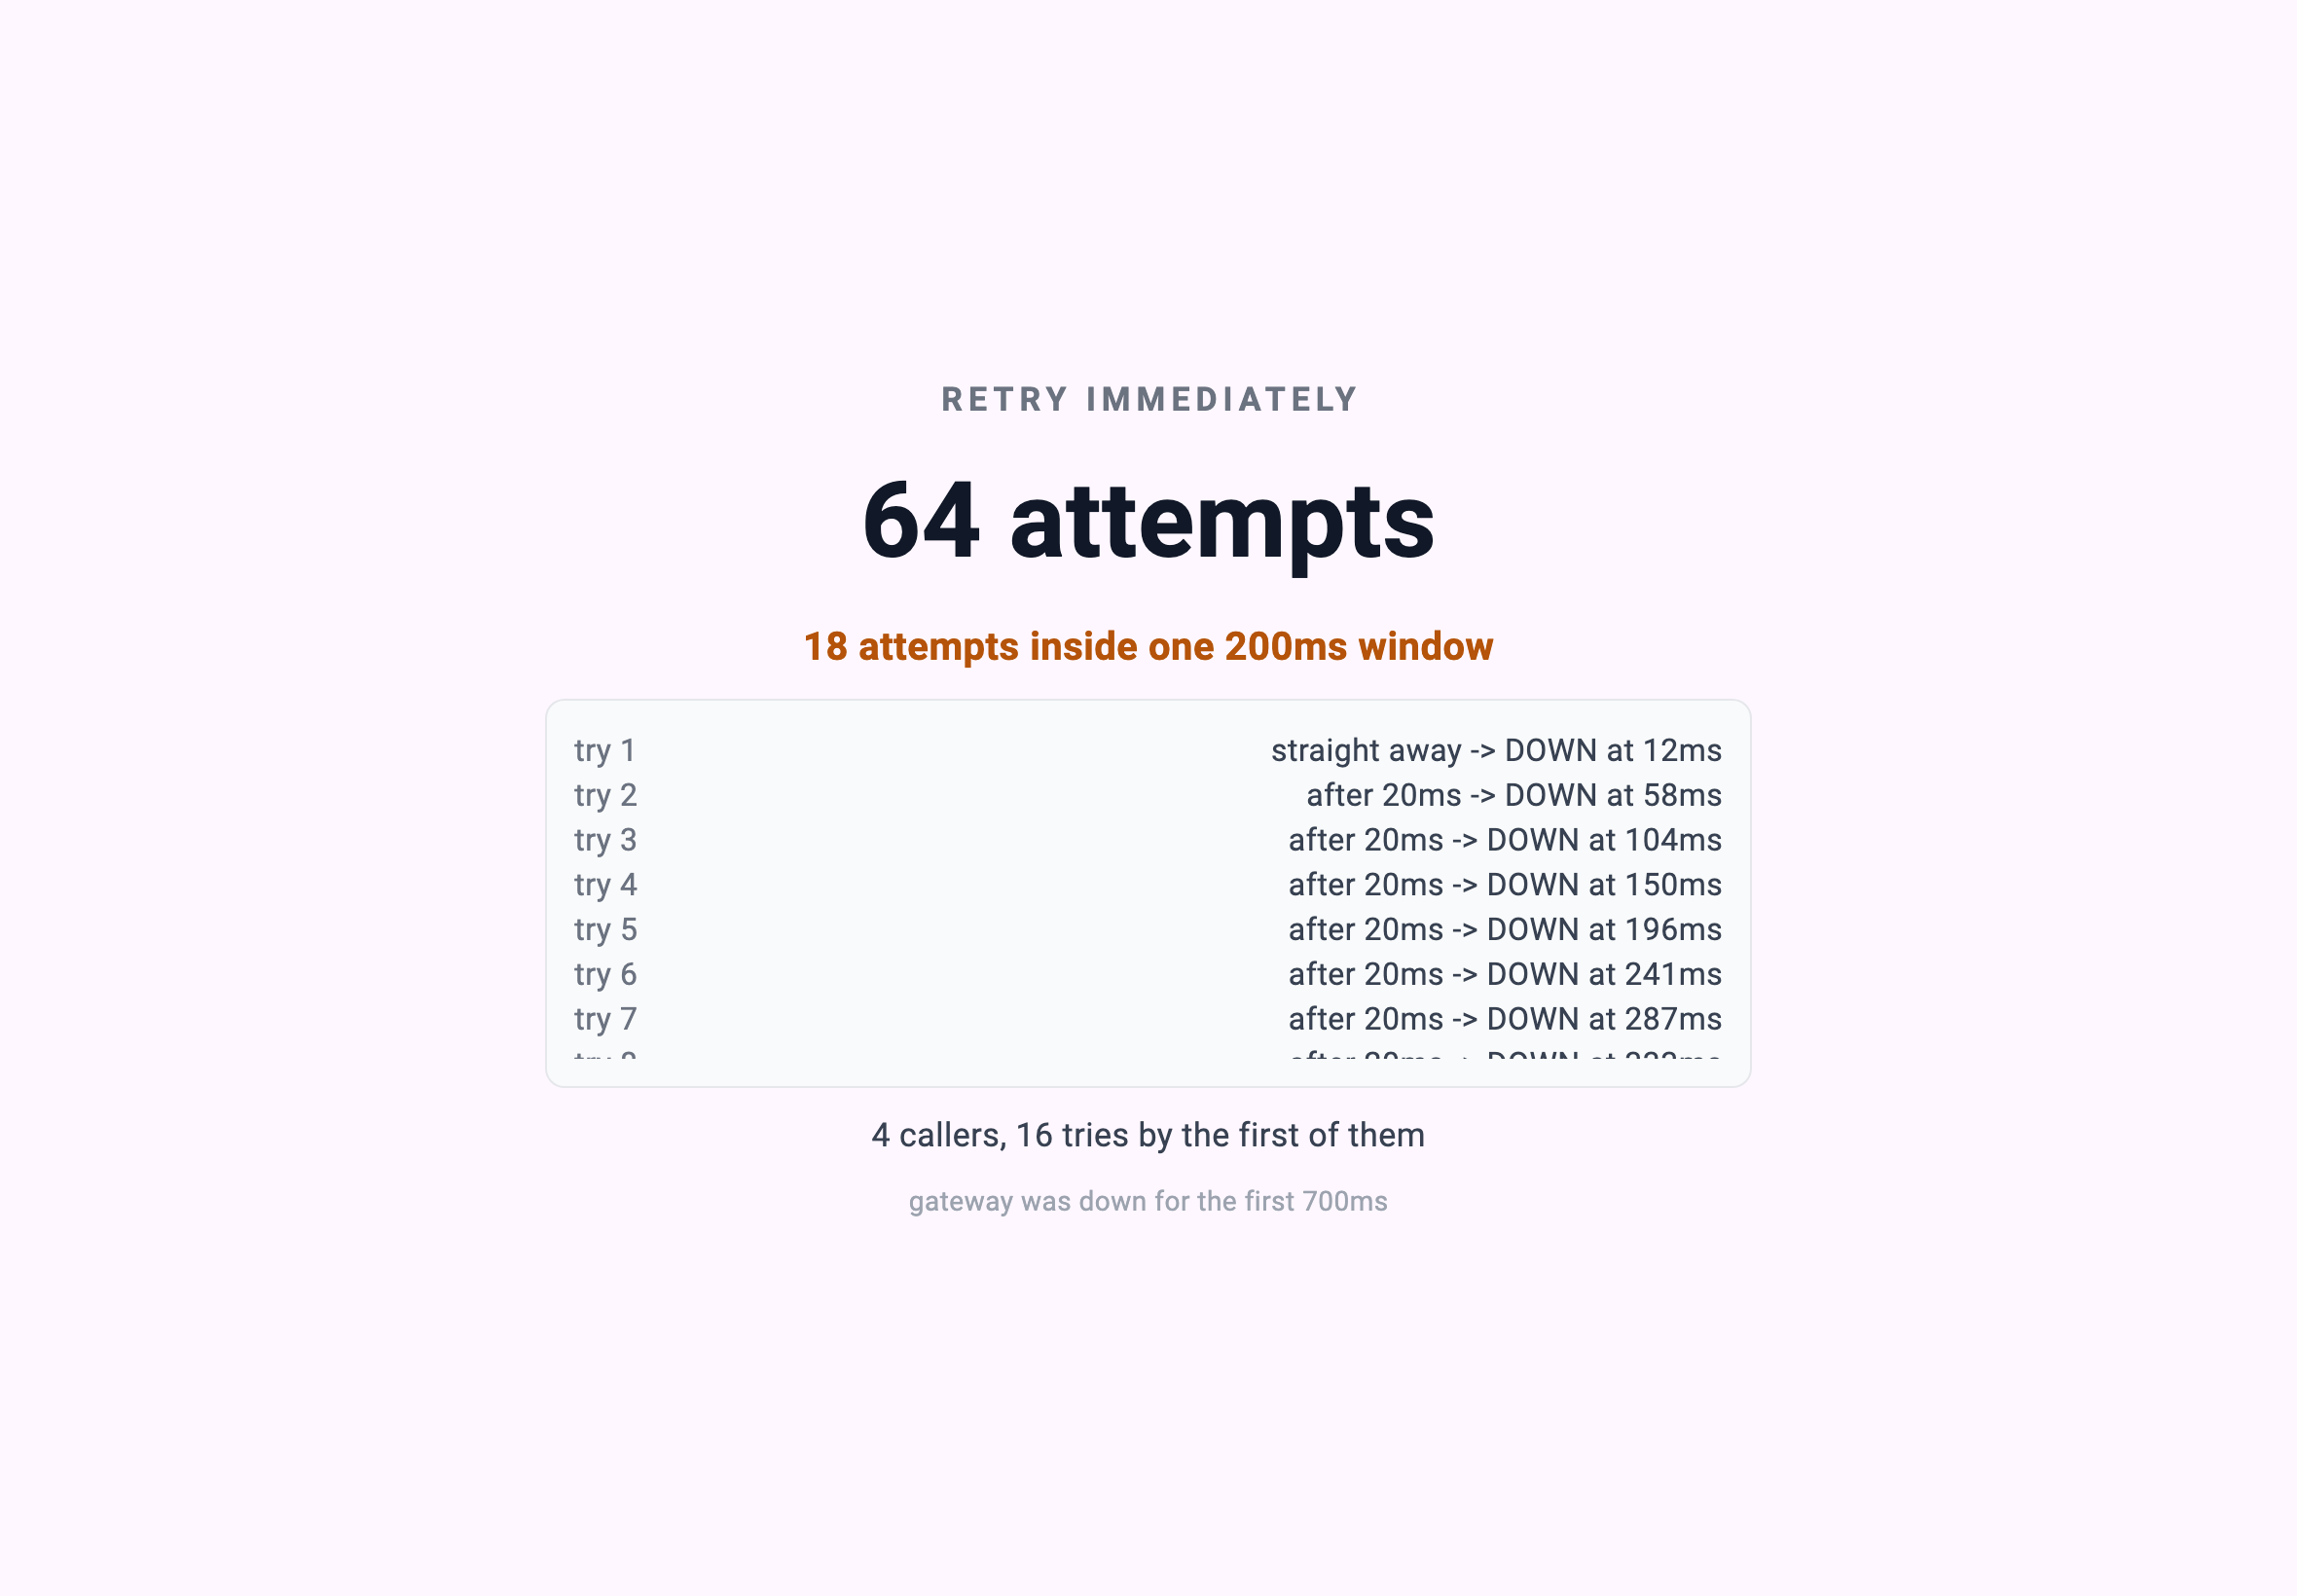
RETRY IMMEDIATELY: 4 callers, 64 attempts total, 4 accepted, peak 18
  caller 1 attempt 1: straight away -> DOWN at 12ms
  caller 1 attempt 2: after 20ms -> DOWN at 58ms
  ...
  caller 1 attempt 16: after 20ms -> ACCEPTED at 708ms
통과했다. 700밀리초 장애를 넘겼고 네 명 다 결제됐다.
그리고 게이트웨이는 그동안 64번 맞았다.
두 배씩 늘리고, 흔든다
@override
int waitBefore(int n) {
  if (n == 1) return 0;
  final base = 60 * (1 << (n - 2)); // 60, 120, 240, 480 ...
  // Full jitter: anywhere in [0, base]. Spreading matters more than being
  // punctual — nobody is waiting on an exact millisecond here.
  return _rng.nextInt(base + 1);
}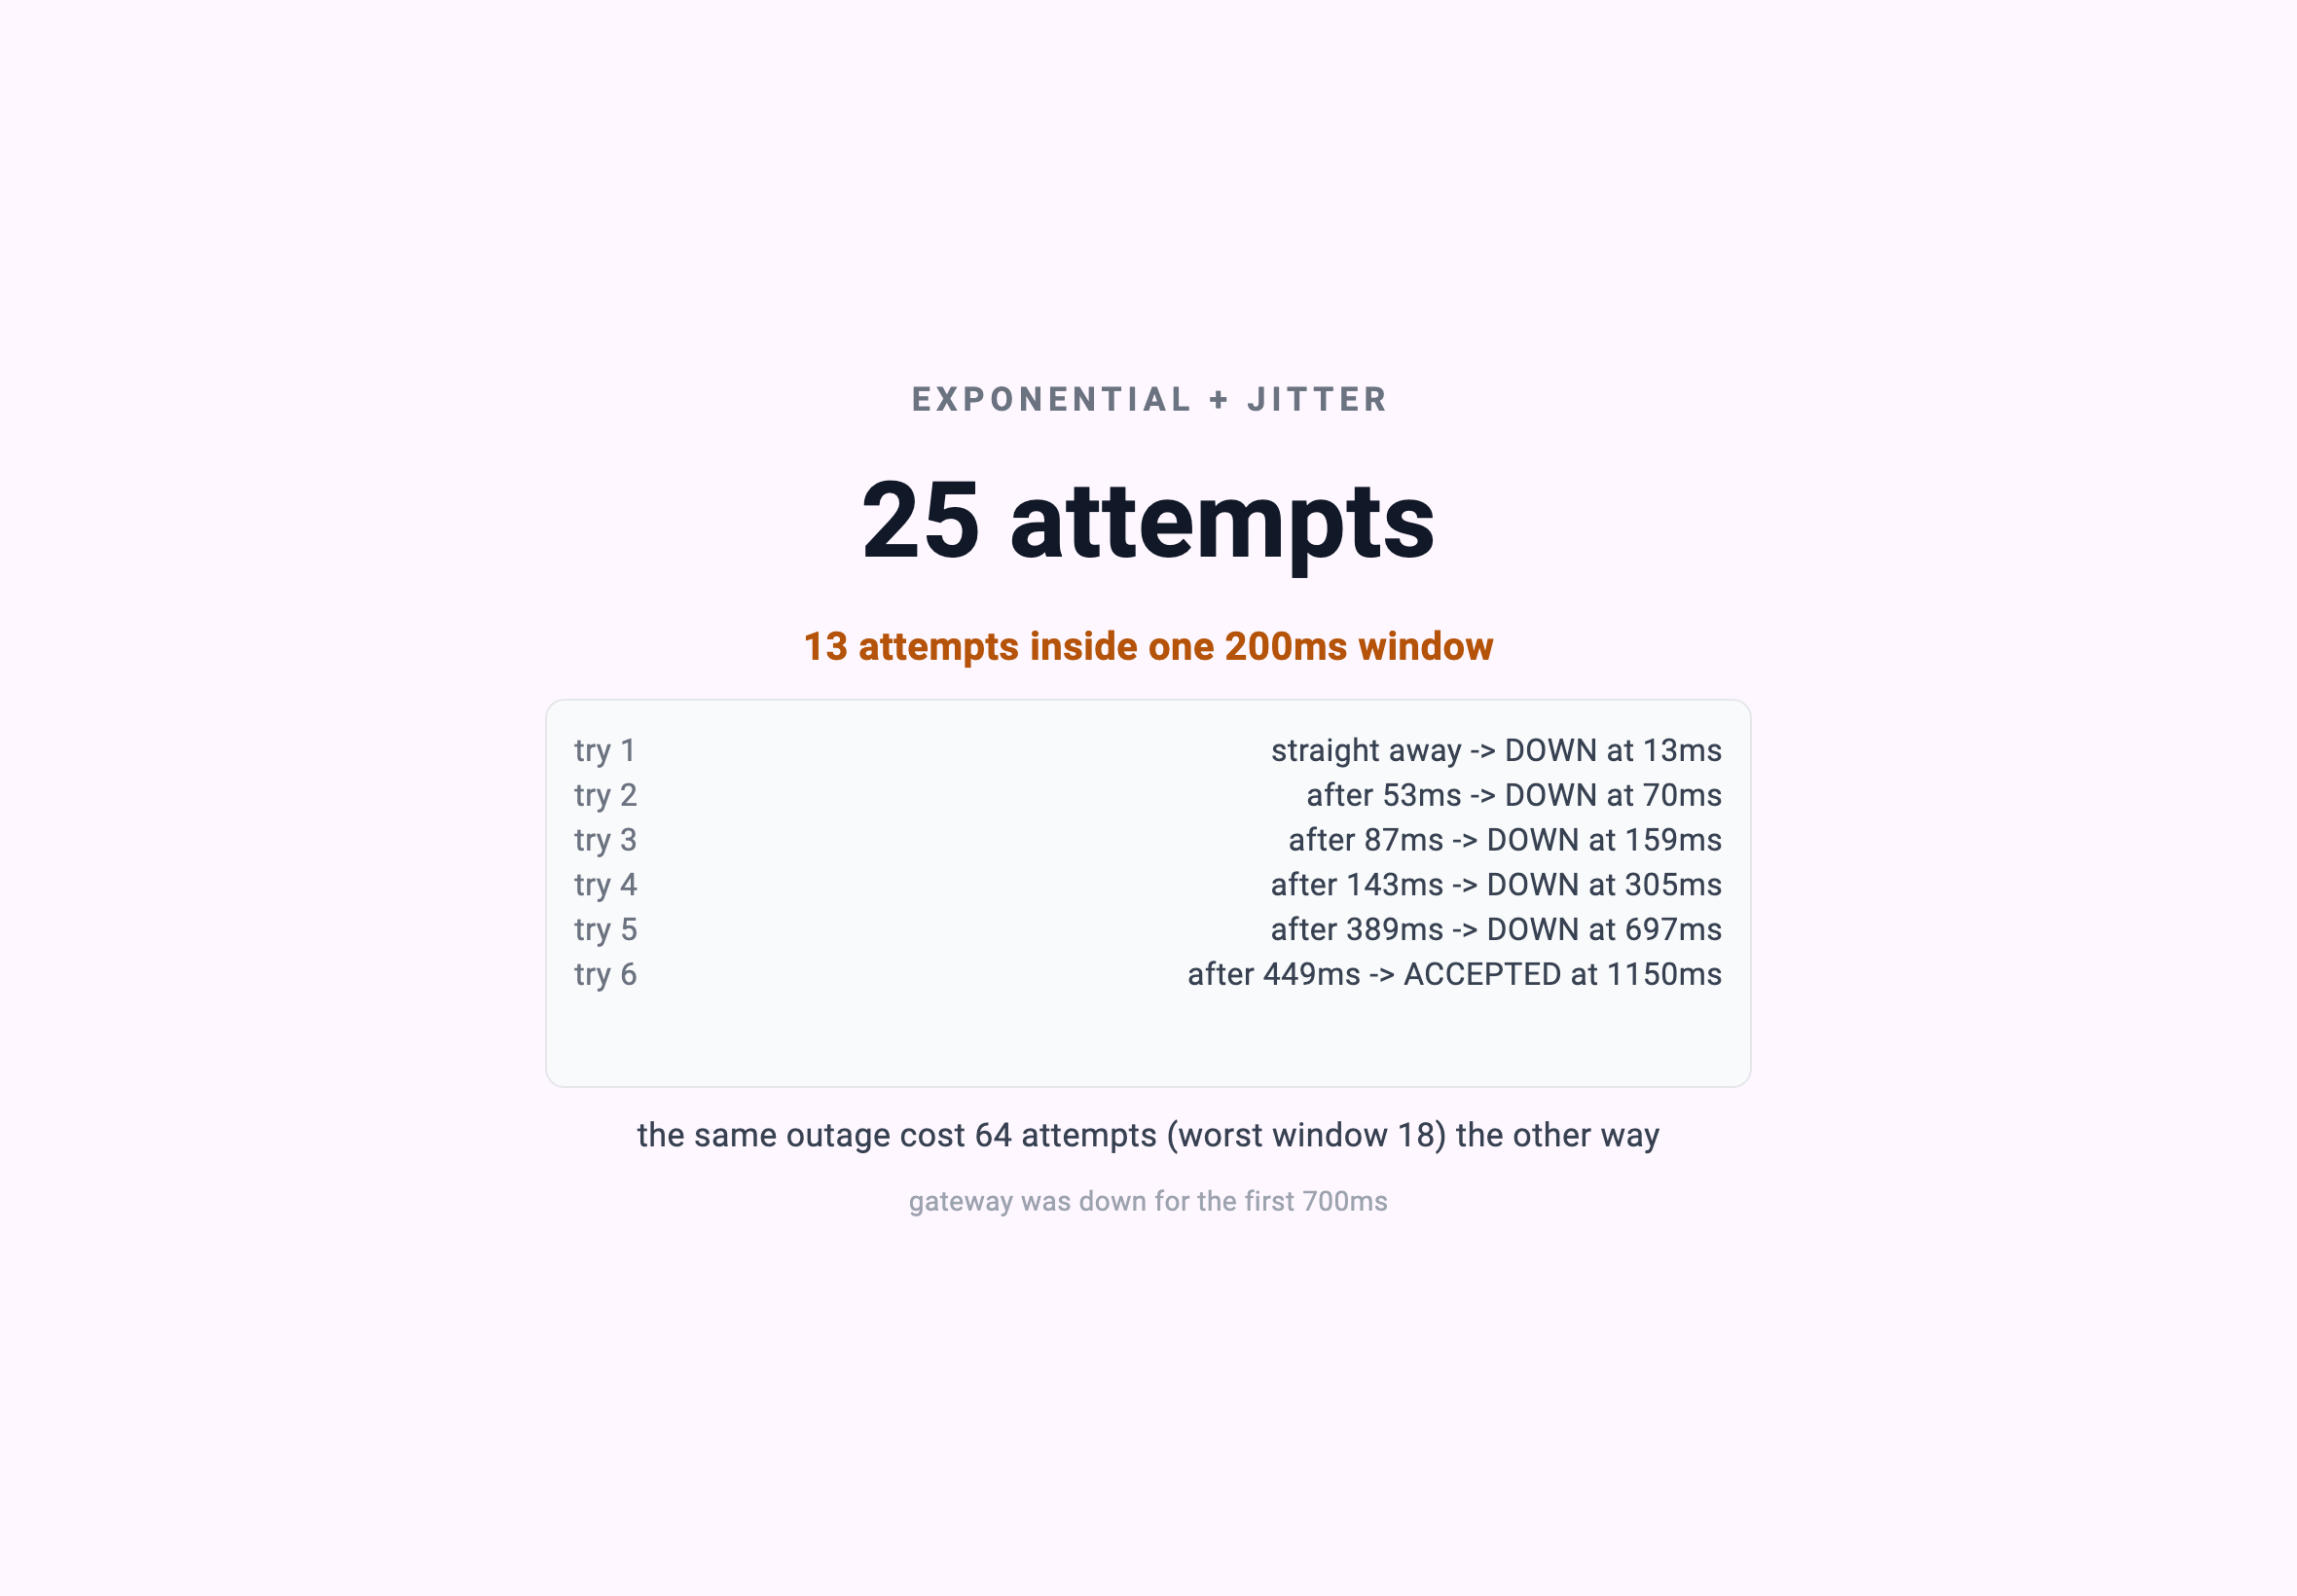
EXPONENTIAL + JITTER: 4 callers, 25 attempts total, 4 accepted, peak 13
  caller 1 attempt 1: straight away -> DOWN at 13ms
  caller 1 attempt 2: after 53ms  -> DOWN at 70ms
  caller 1 attempt 3: after 87ms  -> DOWN at 159ms
  caller 1 attempt 4: after 143ms -> DOWN at 305ms
  caller 1 attempt 5: after 389ms -> DOWN at 697ms
  caller 1 attempt 6: after 449ms -> ACCEPTED at 1150ms
같은 장애, 같은 인원, 같은 결과. 네 명 다 결제됐다.
시도는 64번에서 25번. 2.6배 적다.
두 배 늘리는 것과 흔드는 것은 다른 일이다
여기가 이 편이 하고 싶은 말이다.
지수 백오프는 다들 안다 — 60, 120, 240, 480. 지터는 자주 빠진다. 그런데 부르는 쪽이 하나면 지터는 있으나 마나고, 여럿이면 지터가 전부다.
이유는 단순하다. 네 명이 같은 순간에 실패했으면, 지터가 없으면 네 명이 같은 순간에 돌아온다. 60ms 뒤에 넷, 180ms 뒤에 넷, 420ms 뒤에 넷. 게이트웨이는 방금 자기를 넘어뜨린 그 봉우리를 계속 맞는다.
위 로그를 보면 대기가 53, 87, 143, 389, 449로 어느 것도 60·120·240·480이 아니다. 흔들린 값이다.
검증이 그걸 확인한다.
# Backing off must actually cost the gateway less, otherwise the whole point
# is lost: everybody still gets through, but fewer of them arrive at once.
assert polite["attempts"] < hammer["attempts"], (polite["attempts"], hammer["attempts"])
assert polite["peak"] < hammer["peak"], (polite["peak"], hammer["peak"])
둘 다 통과했다는 것도 검사한다
이게 없으면 검사가 거짓말한다. 백오프가 부하를 줄이는 가장 쉬운 방법은 포기하는 것이기 때문이다.
echo "$HAMMER" | grep -q "4 accepted" || { echo "   hammering did not get everybody through"; exit 1; }
echo "$POLITE" | grep -q "4 accepted" || { echo "   backoff did not get everybody through"; exit 1; }
그 다음에야 부하를 비교한다.
   attempts 64 -> 25
   peak in one 200ms window 18 -> 13
   same outage, both got through · 64 -> 25 attempts · spike 18 -> 13
총량과 봉우리를 둘 다 본다. 총량만 보면 "그냥 천천히 하니까 적어진 것"과 구별이 안 되고, 봉우리가 줄어야 게이트웨이 입장에서 실제로 편해진 것이다.
화면이 초록색으로 거짓말할 뻔했다
만들면서 나온 것이다.
처음엔 화면 아래에 판정 문장을 넣었다. "게이트웨이가 부르는 사람 수보다 세게 맞았다"는 경고인데, 그게 초록색으로 렌더됐다.
색은 상태에 따라 바뀌게 해 놨는데, 정작 그 문장의 색은 화면 정의에 #166534 로 박혀 있었다. 로그는 정확했고, 픽셀만 틀렸다.
LLM이 식물을 인용해야 한다면에서 잡았던 것과 같은 종류의 결함이 다시 나왔다. 그때도 근거 0건인 답이 초록색이었다.
고치면서 판정 자체를 뺐다.
// The screen reports what was counted. It does not grade it — the
// comparison is the article's job, and a screen that grades tends to
// grade in a colour that disagrees with its own sentence.
화면은 센 것을 말하고, 비교는 글이 한다. 판정하는 화면은 판정과 색이 어긋나기 쉽고, 어긋나면 색이 이긴다.
이 샘플의 범위
봉우리 차이가 크지 않다 (18 → 13). 총 시도는 2.6배 줄었는데 봉우리는 1.4배다. 이유가 있다 — stdio 전송이 요청을 직렬화해서 네 명이 진짜로 같은 순간에 도착하지 못한다. 둘 다 "예약됐습니다"에서 만난 것과 같은 제약이다. 실제 HTTP 게이트웨이라면 이 차이가 훨씬 클 것이고, 이 샘플은 그걸 안 보였다.
부하가 장애를 늘리지 않는다. 이 게이트웨이는 700밀리초 뒤에 무조건 살아난다. 실제로는 두들길수록 늦게 살아나고, 그 되먹임이 이 문제를 진짜 문제로 만드는 부분인데 모델에 없다.
서킷 브레이커가 없다. 계속 실패하면 아예 시도를 멈추고 잠시 뒤에 한 번만 떠보는 게 다음 단계고, 안 만들었다.
멱등성은 이미 다른 편에 있다. 재시도가 안전하려면 같은 요청이 두 번 들어가도 되어야 하고, 그건 계산대가 없는 동안이 다룬 부분이다. 이 편만 읽고 재시도를 붙이면 이중 결제가 난다.
네 명이 전부다. 실제 스파이크는 수천이다. 자릿수가 다르면 다른 이야기가 된다.
남는 것
재시도는 붙이기 쉽다. 한 줄이면 된다.
그리고 그 한 줄이 남의 장애를 길게 만든다. 짧게 죽을 서비스를 계속 죽어 있게 하는 건 대개 그 서비스를 쓰는 쪽의 재시도 루프다.
기다리는 시간을 늘리는 것과 서로 다르게 기다리는 것은 다른 일이고, 여럿이 붙는 시스템에서는 뒤엣것이 더 중요하다.
한 줄 더 쓰는 값으로는 싸다.
확인 과제
같은 예약을 연달아 두 번 보내 보세요. 두 번째가 예약을 하나 더 만들지 않는다는 것을 보이고, 어느 쪽이 그것을 보장했는지 설명하세요.